
NVIDIA HGX B300は何が進化したのか?H200・B200比較と公開レビューで見る大規模AI基盤
NVIDIA HGX B300 GPUサーバー 技術コラム | 2026年10月版
みなさんこんにちは。アプライド広域システム営業部です。
大規模言語モデル(LLM)や推論AIの導入を検討するとき、「GPUの演算性能が高ければ、処理も速くなる」と考えがちです。しかし、実際の処理性能には、モデルを保持するGPUメモリ、メモリからデータを読み出す速度、複数GPU間の通信も大きく関わります。
NVIDIA HGX B300は、Blackwell Ultra GPUを8基搭載し、大容量メモリと高速通信を組み合わせたAIプラットフォームです。
今回は、H200・B200との仕様比較、公開されている実機レビューとベンチマーク、具体的なユースケースから、HGX B300の特徴を技術的に読み解きます。
※本記事の実機評価は、出典に記載した他社システムの公開情報を紹介するものです。
LLMの性能を決める「演算・メモリ・通信」
LLMの推論処理は、大きく「Prefill」と「Decode」に分けられます。
| 処理段階 | 主な処理 | 性能を見るポイント |
|---|---|---|
| Prefill | 入力された文章や情報をまとめて処理する | 入力長、演算性能、最初の応答までの時間 |
| Decode | それまでの文脈を参照しながら、出力トークンを生成する | メモリ帯域、KVキャッシュ、生成中の応答速度 |
一般に、Prefillは演算性能、Decodeはメモリからデータを読み出す帯域の影響を受けやすい処理です。ただし、バッチサイズ、キャッシュ、投機的デコードなどの実行条件によって、ボトルネックは変化します。
さらに、大規模モデルを複数GPUに分割すると、GPU間でのデータ交換が必要になります。GPUの仕様を見る際には、演算性能と合わせて、メモリ容量・帯域・通信性能を確認することが重要です。
H200・B200・B300を比較すると、何が違うのか
以下は、データセンター向けSXM GPUの比較です。容量・帯域は1GPU当たりのメーカー公表値で、アプリケーションの実測値とは区別しています。
| 比較項目 | H200 SXM | B200 SXM | B300 SXM/HGX B300 |
|---|---|---|---|
| アーキテクチャ | Hopper | Blackwell | Blackwell Ultra |
| GPUメモリ | 141GB HBM3e | 180GB HBM3e | 270GB HBM3e※ |
| GPUメモリ帯域 | 4.8TB/s | 8TB/s | 7.7TB/s※ |
| GPU当たりのNVLink帯域 | 900GB/s | 1,800GB/s | 1,800GB/s |
※B300は、今回確認したNVIDIA Blackwell Ultraデータシートの「HGX B300」欄を採用しています。288GB/8TB/sと記載された資料もあるため、導入機の仕様は個別に確認します。NVLinkの値はGPU当たりの公称帯域で、特定のGPU間の実効転送速度を示すものではありません。
B200からの進化は、メモリ容量と低精度演算に注目
上表の仕様では、B300のGPUメモリ容量はB200の1.5倍です。モデルを保持した後に、KVキャッシュや同時処理のための領域を確保しやすくなる点が、運用上の検討ポイントになります。
また、NVIDIAのHGX仕様表では、8GPU構成の密行列FP4 Tensor Core性能はB200が72PFLOPS、B300が108PFLOPSで、B300は1.5倍です。
一方、FP8の公称性能は両者とも72PFLOPS(疎行列条件)、NVLinkのGPU当たり帯域も1.8TB/sで共通です。したがって、実際の改善幅は、モデルが必要とするメモリ容量、演算精度、Attention処理、ソフトウェア最適化などによって変わります。
FP4を活用する場合も、対応する量子化方式・実行環境と、対象モデルでの精度評価が必要です。
科学技術計算では、必要な演算精度を確認
AI向けの低精度演算性能と、科学技術計算で使われるFP64性能は別の指標です。
NVIDIAのHGX仕様表では、8GPU合計のFP64/FP64 Tensor Core欄は、B200が296TFLOPS、B300が10TFLOPSと記載されています。倍精度演算を重視する解析では、使用ソフトウェアと演算精度を確認し、H200なども含めて選定する必要があります。
2TB超のGPUメモリは、どのように効くのか
大規模モデルの例として、DeepSeek-R1は総パラメータ数671B、トークン当たりの活性化パラメータ数37BのMoEモデルです。
MoEは、処理するトークンに応じて一部のエキスパートを選択して計算します。GPUメモリに全モデルの重みを置く構成では、容量の見積りに総パラメータ数を使います。
671Bモデルの重み容量を、パラメータ当たりのバイト数から単純計算すると、次のようになります。
| 重みの保持精度 | 単純計算 | 重み容量の概算 |
|---|---|---|
| BF16/FP16 | 671B ×2バイト | 約1,342GB |
| FP8 | 671B ×1バイト | 約671GB |
| 4bit | 671B ×0.5バイト | 約336GB |
※10進GBによる重みのみの概算です。量子化情報、KVキャッシュ、実行時バッファなどは含みません。各精度での動作を保証するものではありません。
HGX B300の2TB超のGPUメモリは、大規模な重みを保持しながら、実行時に必要な領域を確保するうえで有利に働きます。
特に、長い技術文書を扱うRAG、長時間の対話履歴を参照するAIエージェント、多数ユーザーからの同時利用では、モデルを読み込んだ後に残る容量が重要です。
なお、8GPUのメモリを活用するには、モデル並列などの設定が必要です。また、学習では勾配、オプティマイザー状態、活性値などのメモリも加わるため、推論とは分けて容量を見積もります。
NVLinkとConnectX-8は、通信する場所が違う
複数GPUを使う環境では、「サーバー内部」と「サーバー間」の通信を分けて考えます。
| 通信する場所 | 主な技術 | 主な役割 |
|---|---|---|
| サーバー内部のGPU間 | NVLink/NVSwitch | モデル並列や分散処理に伴うGPU間のデータ交換 |
| 複数サーバー間 | ConnectX-8、Ethernet/InfiniBand | 複数ノードにまたがる計算やデータ転送 |
HGX B300では、第5世代NVLink/NVSwitchが8GPUの連携を支えます。今回のQCTモデルでは、さらにConnectX-8を8基搭載し、800Gb/sクラスのネットワークに対応します。
複数台へ拡張する場合は、通信方式、スイッチ、ストレージ、ソフトウェア設定まで含めて設計する必要があります。GPUを増やした効果を得るには、計算に必要なデータを供給し、GPU同士が待たずに連携できる構成が重要です。
公開ベンチマーク:大規模LLMを高いスループットで処理
Supermicroは、HGX B300を8GPU搭載したシステムによるMLPerf Inference v6.1の結果を公開しています。
同社の公開記事に掲載された数値を抜粋すると、次のとおりです。
| モデル | Serverシナリオ | Offlineシナリオ |
|---|---|---|
| DeepSeek-R1 | 約67,000 tokens/s | 約70,000 tokens/s |
| GPT-OSS-120B | 約107,000 tokens/s | 約109,000 tokens/s |
| Llama 2 70B | 約110,000 tokens/s | 約111,000 tokens/s |
※公開記事の丸め値。対象機種はSYS-822GS-NB3RTおよびAS-8126GS-NB3RTで、いずれもB300×8GPUの構成です。QCT製品の実測値ではありません。
ここで示されているtokens/sは、システム全体で処理するトークン量です。1人の利用者に対する文章生成速度とは区別して読む必要があります。
実際の導入評価では、次の指標を合わせて確認します。
- TTFT: 入力してから最初のトークンが返るまでの時間
- TPOT: 出力トークン当たりの生成時間
- スループット: システム全体で単位時間に処理できる量
- 同時処理数: 必要な応答速度を維持しながら処理できるリクエスト数
精度・量子化方式、入力長、出力長、実行エンジンなども性能に影響します。自社の使い方に近い条件で評価することが、適切なGPU選定につながります。
技術特性から考える、HGX B300のユースケース
| ユースケース | 活かせる特性 | 構成検討で確認する項目 |
|---|---|---|
| 大規模MoEモデルの推論・評価 | 大容量HBM、GPU間通信、低精度演算 | 総重み容量、量子化精度、モデル並列・エキスパート並列の対応 |
| 長文RAG・AIエージェントの社内提供 | KVキャッシュ領域、メモリ帯域、同時処理能力 | コンテキスト長、同時利用人数、TTFT・TPOTの目標 |
| VLM・画像AIの研究開発、追加学習 | 複数GPUの演算資源と高速通信 | 画像サイズ・枚数、学習方式、バッチサイズ、CPUメモリ・ストレージ |
例えば、製造業の技術文書を横断検索するRAGでは、検索対象の選び方や入力長によって、GPUが処理する量が変わります。画像と文章を扱うVLMでは、画像の解像度や入力枚数も計算負荷に関係します。
追加学習についても、LoRAなどの手法とフルパラメータ学習では必要な計算資源が異なります。「どのモデルで、何を、どの規模で実行するか」を整理することで、HGX B300の性能を活かせる構成を選びやすくなります。
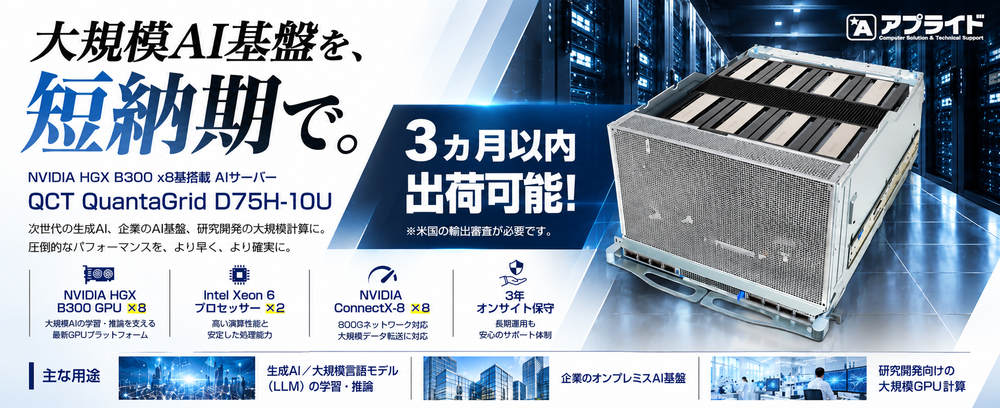
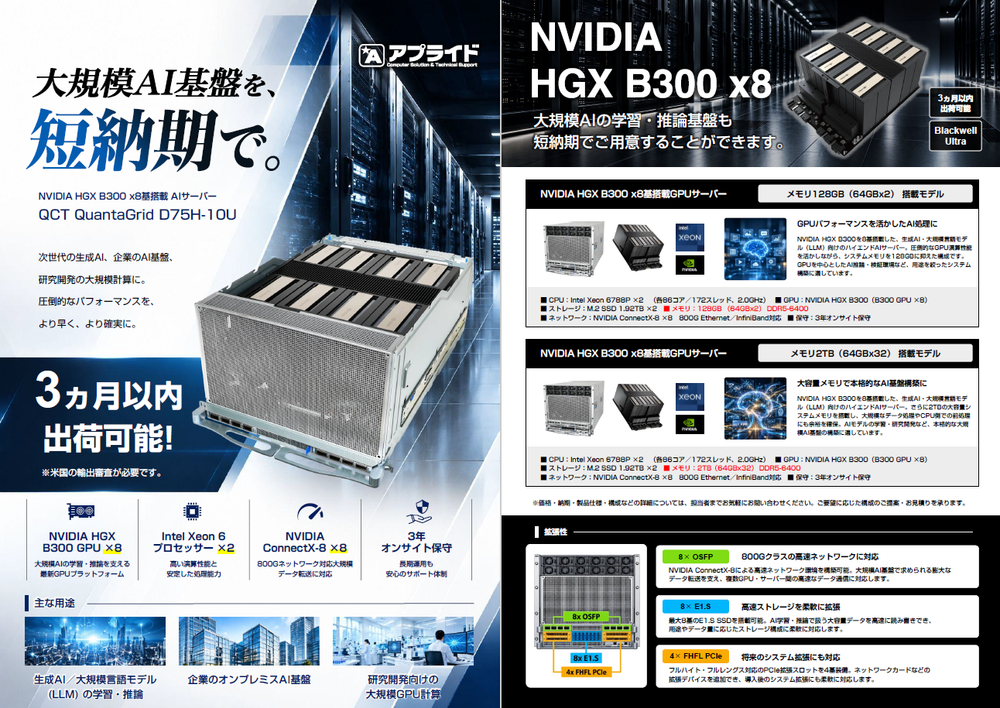
HGX B300を空冷10Uで導入する「QuantaGrid D75H-10U」
アプライドが今回ご紹介するのは、QCT「QuantaGrid D75H-10U」をベースとしたHGX B300搭載サーバーです。
主な構成は、以下のとおりです。
| 項目 | ご提案構成 |
|---|---|
| GPU | NVIDIA HGX B300(B300 GPU ×8基) |
| CPU | Intel Xeon 6788P ×2基(各86コア/172スレッド) |
| システムメモリ | 128GB(64GB×2枚)/2TB(64GB×32枚)の構成例 |
| ストレージ | M.2 SSD 1.92TB ×2基 |
| ネットワーク | NVIDIA ConnectX-8 ×8基、800G Ethernet/InfiniBand対応 |
| 筐体・冷却 | 10Uラックマウント・空冷 |
| 保守 | 3年オンサイト保守 |
大規模モデルでは、GPUメモリに加えて、モデルの読み込みや前処理を行うCPU側のシステムメモリも重要です。128GB構成は用途を限定した構成例として、対象ワークロードとメーカーの対応・検証条件を確認してご案内します。
空冷方式での導入を検討できる点も本モデルの特徴です。必要な受電容量、空調能力、ラック条件を確認し、ストレージや複数台接続を含めて構成を検討します。
なお、NVIDIA DGXはハードウェア・ソフトウェア・サポートを統合したシステム、HGXはパートナー各社のサーバーに組み込まれるGPUプラットフォームです。同じB300を搭載していても、CPU、システムメモリ、ソフトウェアの提供範囲、保守条件などは製品ごとに確認する必要があります。
そして、このHGX B300搭載サーバーを、最短3ヶ月で。
B300 GPU搭載サーバーは、NVIDIA純正のDGXを含め、長納期となる案件があります。導入予定が決まっているプロジェクトでは、調達期間が検証開始やサービス立ち上げの時期に関わります。
そこでアプライドでは、今回ご紹介したQCT「QuantaGrid D75H-10U」の短納期モデルをご案内しています。
NVIDIA HGX B300搭載・8GPUサーバーが、最短3ヶ月で入手可能!
大規模モデルを扱うためのGPUメモリ、8GPUを連携させる高速通信、そして3年オンサイト保守。必要な計算基盤を、導入スケジュールと合わせてご提案します。
「大規模モデルの検証を早く始めたい」「導入希望日に合わせて調達したい」「DGXとHGXを含め、仕様・価格・納期を比較したい」といったご相談は、アプライドまでお問い合わせください。
本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。
本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。

