
生成AI時代の「GPUネットワーク選定・設計ガイド」
AIシステムにおけるネットワークの重要性
みなさんこんにちは。アプライド広域システム営業部です。
近年、生成AIや大規模言語モデル(LLM)の登場により、AIサーバーや開発用ワークステーションの導入をご検討される企業様が急増しています。
AIシステムをご提案する際、多くのお客様が「どのGPUを何台載せるか」に注目されます。しかし、実はAIの学習スピードやシステムの安定性を大きく左右するのは、サーバー同士やデスクサイド端末を繋ぐ「ネットワーク(配線とスイッチ)」です。
「GPUは最高スペックなのに、なぜか計算が終わらない…」といった失敗を防ぐため、AIサーバーメーカーの視点から、ネットワーク設計の重要ポイントと最新の構成パターンを分かりやすく解説します!
なぜAIサーバーには特別なネットワークが必要なのか?
AIの学習では、1台の機器に収まりきらない膨大なデータを、複数台のAIサーバーや端末で同時に分け合って計算します。このとき、機器同士が「計算結果(勾配やパラメータ)」をミリ秒・マイクロ秒レベルで頻繁にやり取りします。
💡 日常で例えると:巨大なジグソーパズル
100人で巨大なパズルを解いている場面を想像してください。自分の作業が早く終わっても、隣の人とピース(データ)を交換する廊下(ネットワーク)が混雑して渡せなければ、全員の作業がストップしてしまいます。
普通のLANケーブル(TCP/IP)ではダメな理由
一般的なオフィスやWEBサーバーで使われるネットワーク(TCP/IP)は、データを送るたびに「CPU」が割り込み処理を行い、データを何度もメモリ間でコピーします。これでは通信のたびに遅延が発生し、高価なGPUが「データ待ち」でサボってしまう現象(GPUスターベーション)が起きます。
そこで使われるのが、CPUを通さずにGPUとネットワーク機器が直接データをやり取りする「RDMA(Remote Direct Memory Access)」という超高速・低遅延な通信技術です。
2大ネットワークプロトコル:「InfiniBand」vs「RoCEv2」
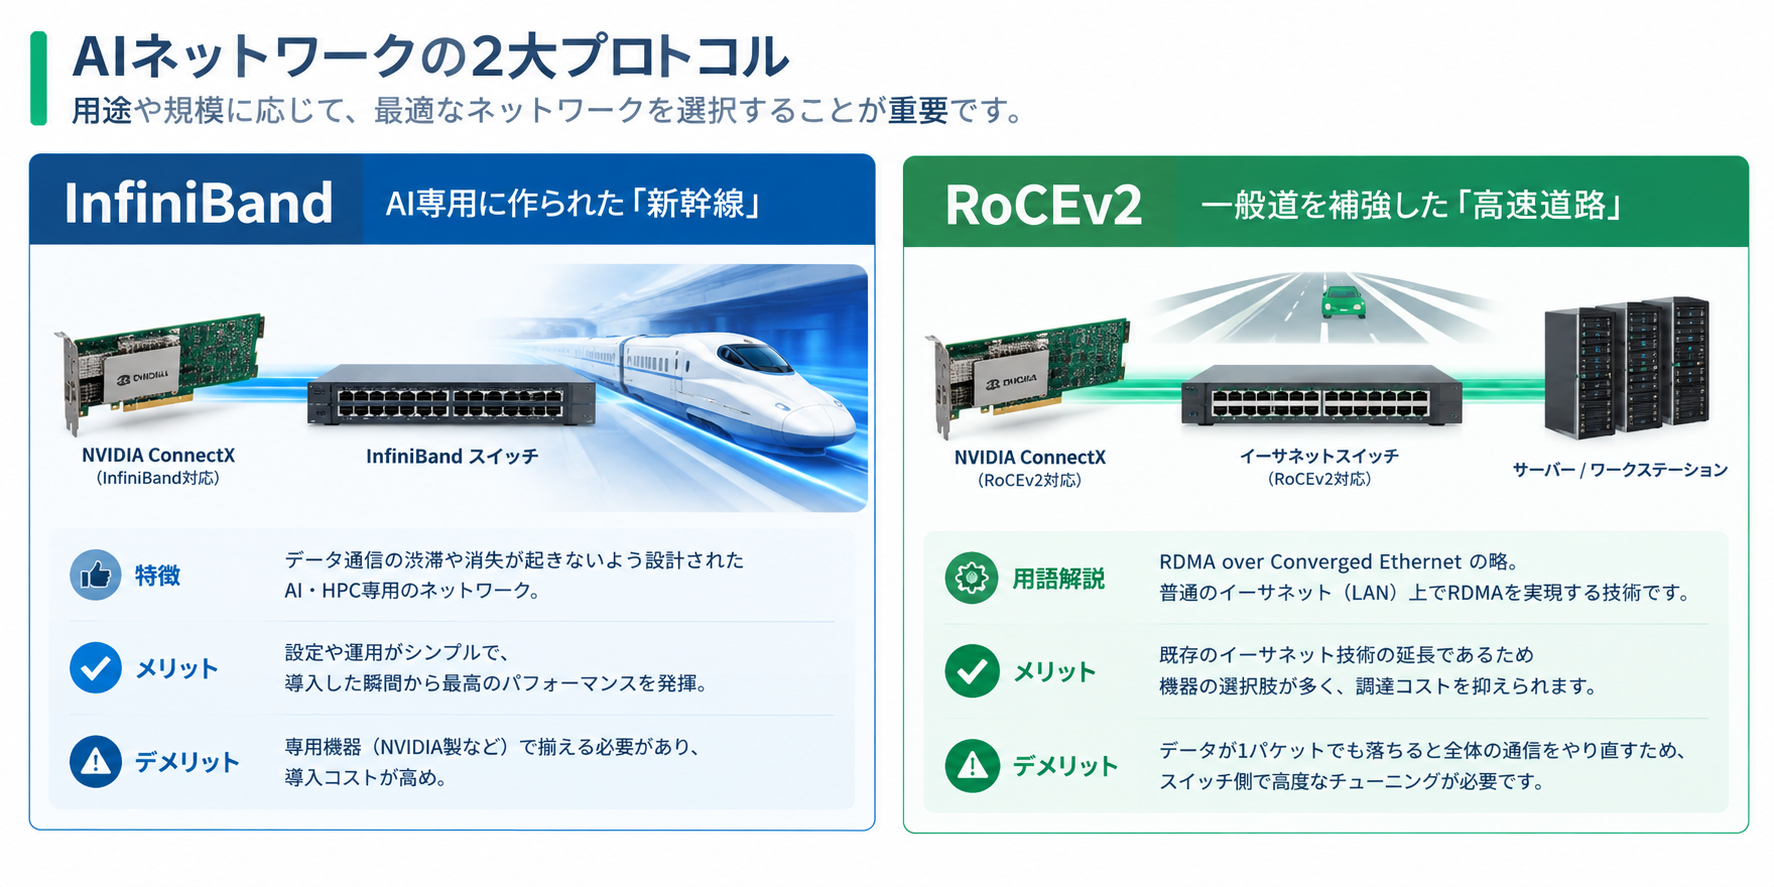
① InfiniBand(インフィニバンド)
特徴: 最初からデータ通信の渋滞やデータ消失が絶対に起きないよう設計された、AI・HPC専用のネットワークです。
メリット: 設定や運用がシンプルで、導入した瞬間から最高のパフォーマンスを発揮します。
デメリット: 専用機器(NVIDIA製など)で揃える必要があり、導入コストが高めです。
② RoCEv2(ロシー・バージョンツー)
用語解説: RDMA over Converged Ethernet の略。普通のイーサネット(LAN)上でRDMAを実現する技術です。
メリット: 既存のイーサネット技術の延長であるため機器の選択肢が多く、調達コストを抑えられます。
デメリット: データが1パケットでも落ちると全体の通信をやり直す性質があるため、データが絶対に落ちない(Lossless)ようにネットワークスイッチ側で極めて複雑なチューニングを行う必要があります。
GPUネットワークの要:NVIDIA ConnectX(スマートNIC)の世代解説
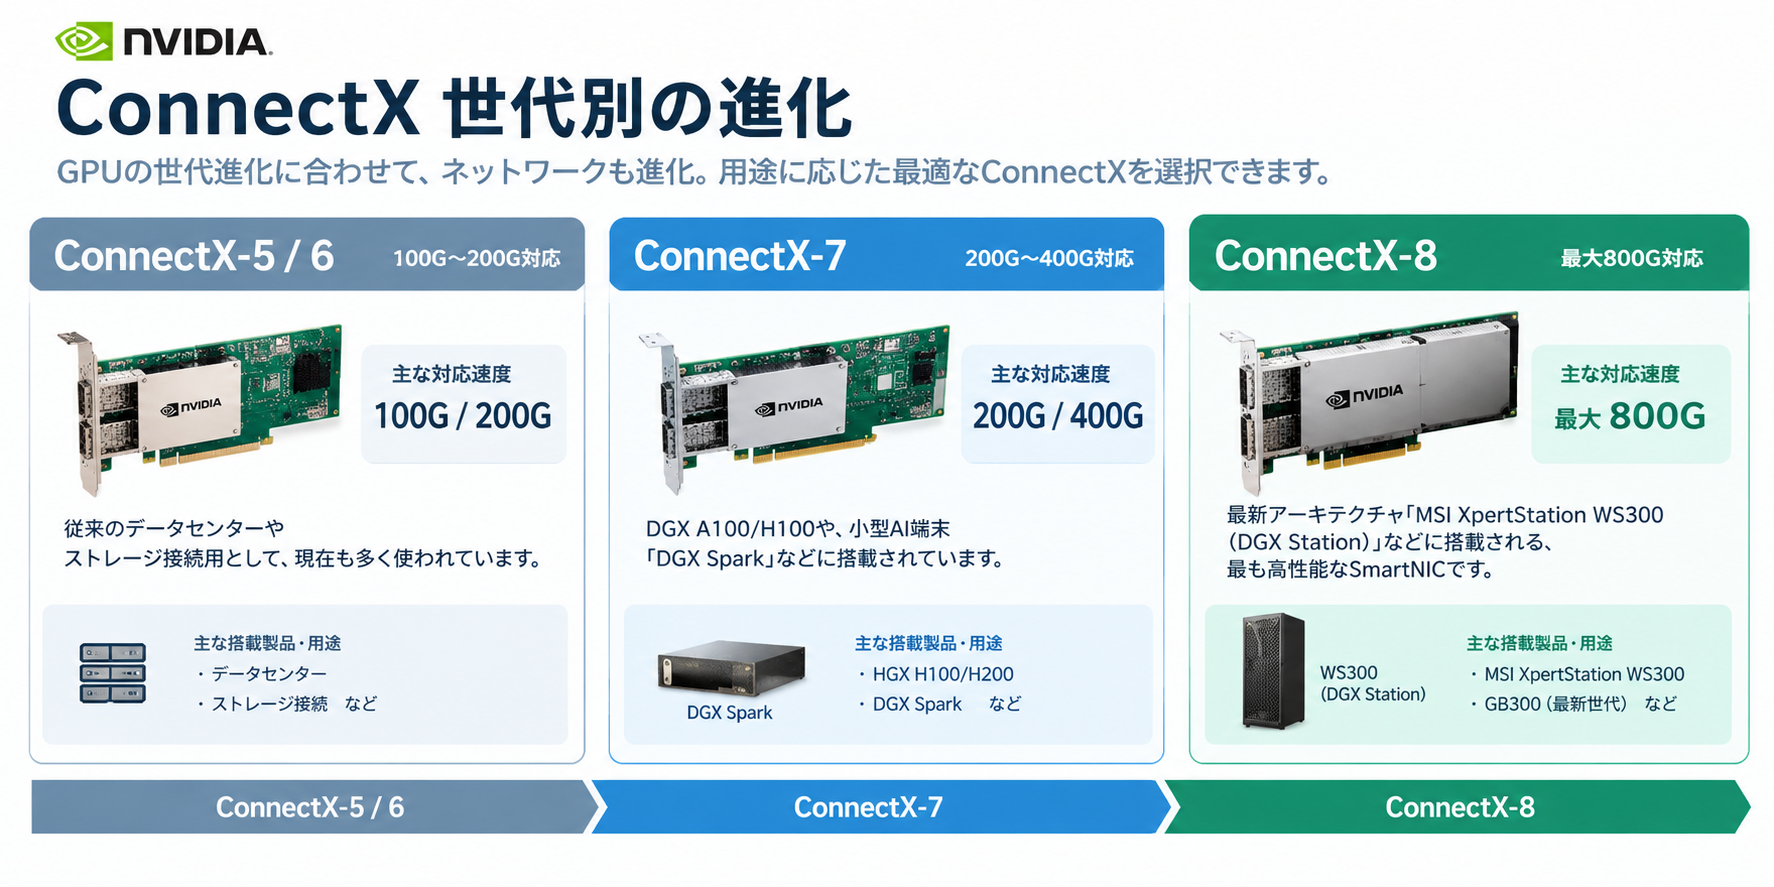
AIサーバーやワークステーションの背面に刺さり、RDMA通信をハードウェアレベルで処理しているエンジンが NVIDIA ConnectX(コネクトエックス) シリーズです。GPUの世代進化に併せて、ConnectXも以下のように進化してきました。
📖 用語解説:NIC / SmartNIC(スマートニック)
サーバーにネットワーク機能を拡張する専用カード(板)のこと。通信処理をCPUから肩代わりして高速化するものをSmartNICと呼びます。
知っておきたい!光ポート規格(QSFPとその発展形)
📖 用語解説:QSFP(Quad Small Form-factor Pluggable)
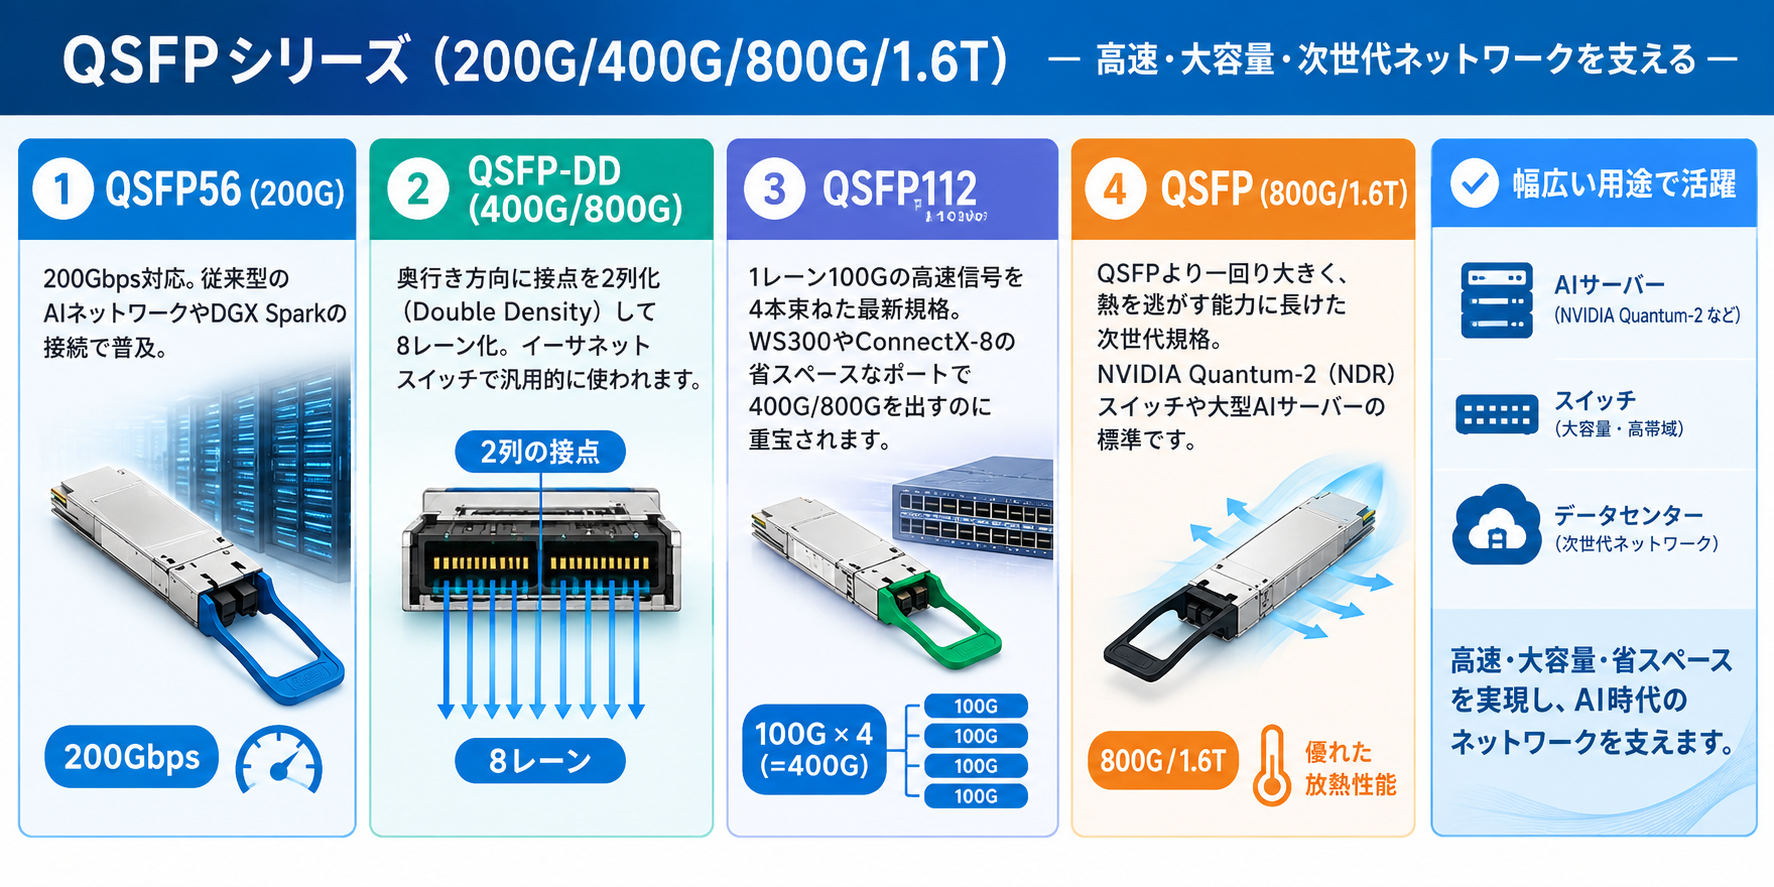
4本の通信レーン(Quad)を束ねて高速化した光トランシーバーの標準形状です。
- QSFP56 (200G): 200Gbps対応。従来型のAIネットワークやDGX Sparkの接続で普及。
- QSFP-DD (400G/800G): 奥行き方向に接点を2列化(Double Density)して8レーン化。イーサネットスイッチで汎用的に使われます。
- QSFP112 (400G): 1レーン100Gの高速信号を4本束ねた最新規格。WS300やConnectX-8の省スペースなポートで400G/800Gを出すのに重宝されます。
- OSFP (800G/1.6T): QSFPより一回り大きく、熱を逃がす能力に長けた次世代規格。NVIDIA Quantum-2(NDR)スイッチや大型AIサーバーの標準です。
実践!デスクサイド端末(DGX Spark / WS300)を活用した構成パターン
小規模なプロトタイピングから、本格的な本番学習まで対応する実用的な構成パターンをご紹介します。
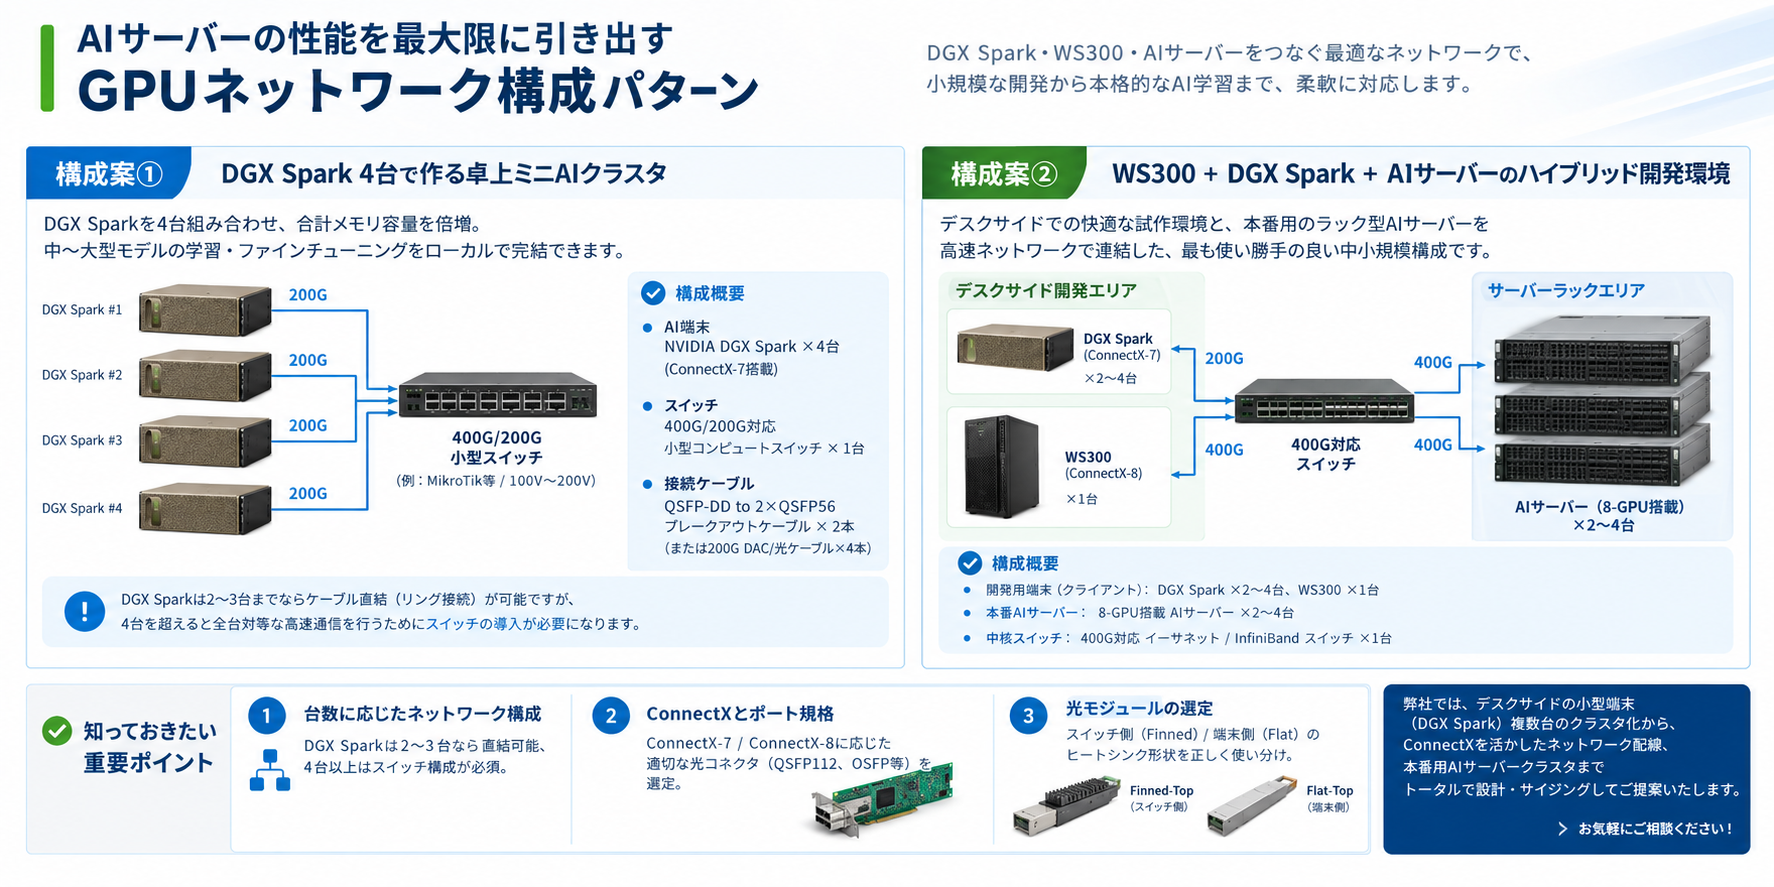
構成案①:人気構成!「DGX Spark 4台」で作る卓上ミニAIクラスタ
オフィスのデスクサイドで静音かつ省スペースに運用できる「DGX Spark」を4台組み合わせ、合計メモリ容量を倍増させて中〜大型モデルの学習・ファインチューニングをローカル完結させる構成です。
AI端末: NVIDIA DGX Spark(ConnectX-7搭載) × 4台
スイッチ: 400G/200G対応 小型コンピュートスイッチ × 1台
接続ケーブル: QSFP-DD to 2×QSFP56 ブレイクアウトケーブル × 2本(または200G DAC/光ケーブル×4本)
特徴: DGX Sparkは2〜3台までならケーブル直結(リング接続)が可能ですが、4台を超えると全台対等な高速通信を行うためにスイッチの導入が必要になります。4台のメモリ空間とGPUパワーが合体し、オフィス環境のまま巨大なLLMのファインチューニングが驚くほど快適に行えます。
構成案②:実践型!「WS300 + DGX Spark + AIサーバー」のハイブリッド開発環境
デスクサイドでの快適な試作環境(WS300 / DGX Spark)と、本番用のラック型AIサーバーを高速ネットワークで連結した、最も使い勝手の良い中小規模構成です。
開発用端末(クライアント):
- NVIDIA DGX Spark(試作・個人開発用) × 2〜4台
- MSI XpertStation WS300(チーム共有・大型モデル検証用) × 1台
本番AIサーバー: 8-GPU搭載 AIサーバー × 2〜4台
中核スイッチ: 400G対応 イーサネット / InfiniBand スイッチ × 1台
接続仕様: DGX Spark(ConnectX-7)および WS300(ConnectX-8 / QSFP112)からスイッチへ接続し、手元で作成したコードやモデルを一瞬で本番サーバー群へデプロイして集中学習を実行します。
まとめ:AIインフラ構築のチェックリスト
AIシステムの導入・拡張をご検討の際は、以下のポイントをぜひご確認ください。
- 台数に応じたネットワーク構成: DGX Sparkは2〜3台なら直結可能、4台以上はスイッチ構成が必須。
- ConnectXとポート規格: ConnectX-7 / ConnectX-8に応じた適切な光コネクタ(QSFP112、OSFP等)を選定しているか。
- 光モジュールの選定: スイッチ側(Finned)/ 端末側(Flat)のヒートシンク形状を正しく使い分けているか。
弊社では、デスクサイドの小型端末(DGX Spark)複数台のクラスタ化から、ConnectXを活かしたネットワーク配線、本番用AIサーバークラスタまでトータルで設計・サイジングしてご提案いたします。お気軽にご相談ください!
↓ハードウェアの選定、サイジングに迷ったらこちら
本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。


本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。

