
【推論時代の最適解】アプライド×MSIのNVIDIA MGXによるベストフィット提案
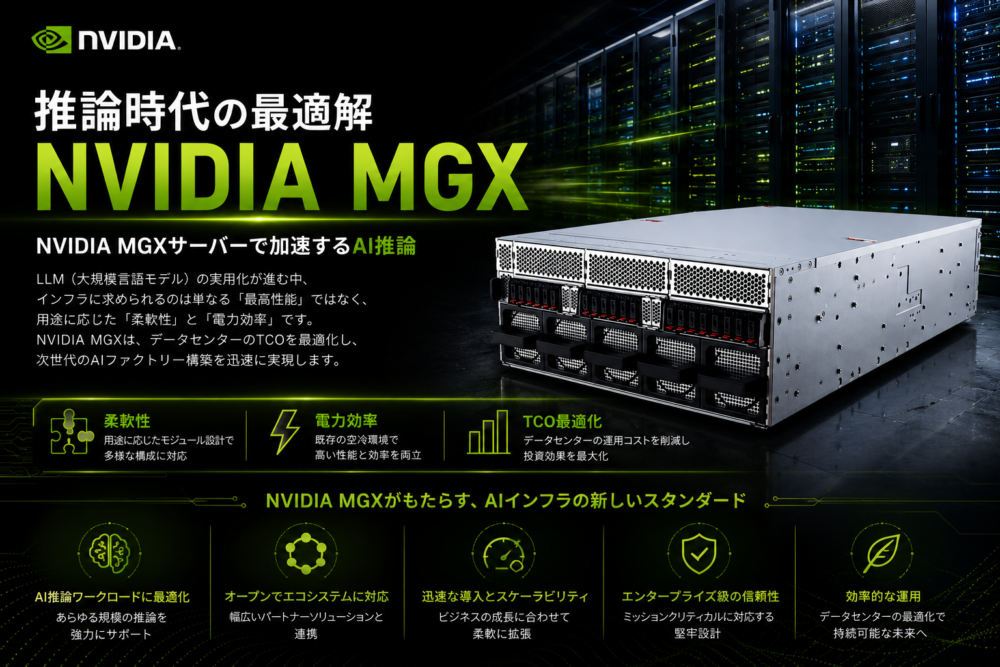
推論時代のNVIDIA MGXによるベストフィット提案
みなさんこんにちは。アプライド広域システム営業部です。
ChatGPTをはじめとするLLM(大規模言語モデル)の実用化が急速に進む中、AIインフラに求められる要件も大きく変化しつつあります。
これまでのAI開発、特に「学習(トレーニング)」のフェーズにおいては、とにかく最高性能のGPUをかき集め、GPUメモリの速度と容量を追求する巨額なデータセンター投資が主流でした。
しかし、モデルが完成し、実際の業務やサービスで活用する「推論(インファレンス)」のフェーズに移行していく中で、新たな課題が浮き彫りになっています。
それは、「学習用の最高峰システム(DGXやHGX)をそのまま推論に使うのは、多くの場合オーバースペックであり、初期投資もランニングコストも過剰になってしまう」という問題です。
これからの推論インフラに求められるのは、単なる「最高性能」ではなく、用途に応じた「柔軟性」と「電力効率」です。
今回は、データセンターのTCO(総所有コスト)を最適化し、無駄のない推論基盤を実現する「NVIDIA MGX」アーキテクチャと、アプライドが提案するベストフィットなサーバー構成について解説します。
昨今のデータセンター事情とNVIDIAプラットフォームの比較
現在、NVIDIAのデータセンター向けプラットフォームには、大きく分けて3つの選択肢が存在します。自社にとって最適な選択はどれか、まずはそれぞれのコンセプトを比較してみましょう。
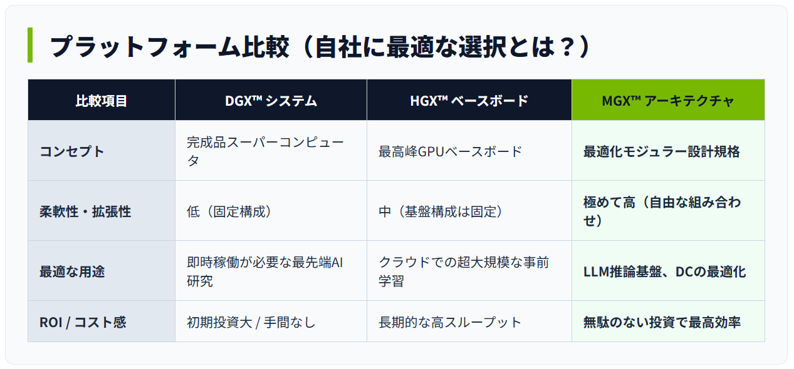
研究開発用途に特化したDGXや、超大規模学習に向けたHGXに対し、MGX(Modular Architecture)はサーバーベンダーが自由にコンポーネントを組み合わせられるよう設計されたモジュール式アーキテクチャです。これが「推論インフラ」において圧倒的な強みを発揮します。
NVIDIAの方向性と「推論インフラ」構築のハードル
最新世代のAI向けGPU(B300やB200など)は圧倒的な性能を誇ります。しかし、最新のNVIDIAのBlackwell世代、ハイエンドデータセンター向けGPUの多くは汎用的なPCIeカード単体としては提供されず、専用基板(HGXなど)による「8基構成」からの導入となるケースが増えています。
これはB300がPCIe規格の物理的な限界を完全に超えてしまったためです。
1.消費電力と冷却の限界(最大の要因)
自社のデータB300の消費電力(TDP)は最大1,000W〜1,400Wに達します。 一般的なPCIeスロットはマザーボードから直接75W、補助電源ケーブルを複数繋いでも350W〜600W程度が供給の限界です。さらに、1,400Wもの猛烈な熱を汎用サーバーの空冷ファンや標準的なPCIeカードのヒートシンクで冷却することは物理的に不可能です。そのため、B300は専用の超大容量電源と、チップを直接液冷(水冷)するシステムを前提としたSXM(またはMGX)モジュール専用となっています。
2.データ通信帯域のボトルネック
大規模言語モデル(LLM)などの処理では、複数のGPU間でテラバイト級のデータを一瞬でやり取りする必要があります。 B300は第5世代「NVLink」を採用し、GPU間で最大1.8 TB/sという驚異的な速度で通信します。一方で、最新のPCIe Gen6規格であっても帯域幅はその数分の一に過ぎません。仮にPCIe版を作っても通信速度がボトルネックとなり、B300の本来の計算性能を全く発揮できなくなってしまいます。
3.物理的なサイズ(基板面積)の問題
B300は、2つの巨大なGPUダイを繋ぎ合わせた構造(GB100)をしており、その周囲には大容量のHBM3eメモリ(最大288GB)が12段積みで配置されています。 これに加えて、1,400Wの電力を安定させるための巨大な電源回路(VRM)を搭載する必要があり、標準的な2スロットや3スロット幅のPCIeカードの基板サイズには到底収まりきりません。
4.AIインフラ市場のニーズの変化
現在、最先端のAI開発を行う企業やクラウド事業者は、「サーバーにGPUを1枚挿す」という使い方はしていません。最初から8基のGPUがNVLinkで密結合された「HGXベースボード」や、ラック全体をひとつの巨大なGPUとして扱う「NVL72」のようなシステム単位での導入が標準になっています。学習のフェーズにおいては最高性能を求める顧客層と、小回りの利くPCIeカードの需要がマッチしなくなったことも大きな理由です。
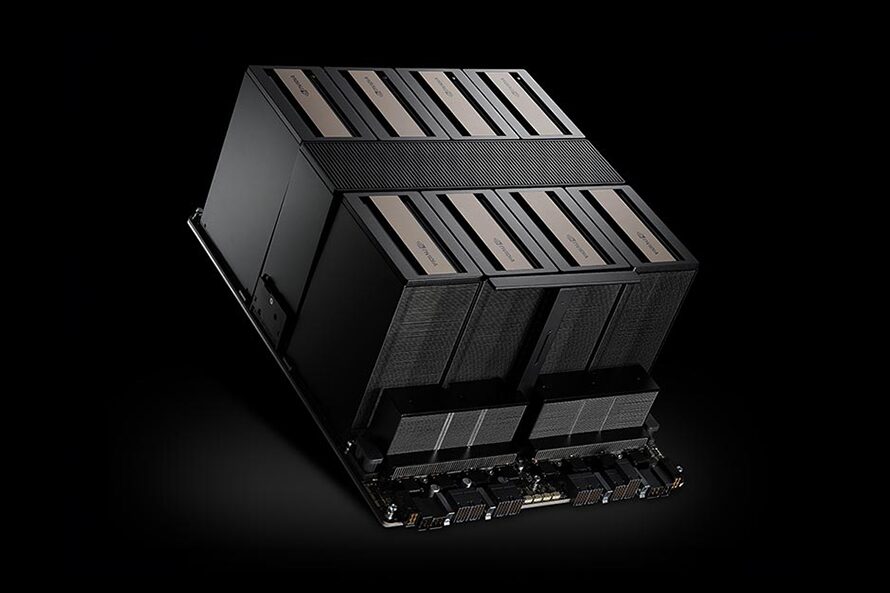
学習のフェーズでは最高スペックが求められていましたが、これからの推論のフェーズでは使用するオープンウェイトのモデル、利用人数、予算に応じて最適な構成が求められます。
また大規模なデータセンターだけでなく、コンテナ型やマイクロデータセンターなどよりエッジの近くでも導入が進んでいます。
推論インフラにおける「MGX」3つの優位性
1.ジャストサイズ構成
2Uサイズから導入可能で、CPUのコア数、メモリ容量、ストレージ、そして搭載するGPUの数まで自由に組み合わせが可能です。小規模なエッジ推論から、大規模なLLMモデルまで、用途に合わせてオーバースペックによる無駄な設備投資を排除します。
2.圧倒的な電力・TCO効率
推論処理のボトルネックとなりやすいメモリ帯域幅を最大化するよう設計されています。電力あたりの処理量を劇的に向上させることで、24時間365日稼働し続ける推論基盤のランニングコスト(OPEX)を最小化します。
3.国内生産 × 短納期・低価格
MGXのモジュール設計は、私たちアプライドが得意とする「カスタマイズ(BTO)生産」と非常に高い親和性を持っています。国内ISO取得工場での高品質な組み込みと、柔軟な仕入れ体制により、お客様にとっての最適構成を短納期かつ低価格でご提供します。
なぜアプライド×MSIの提案が「最適解」なのか?
推論時代の最適化において、重要な鍵を握るのがパートナーシップです。アプライドは、日本市場におけるMSIサーバー製品の「プレミアムディストリビューター」です。
MGXアーキテクチャの開発にいち早く参画し、柔軟で高密度なサーバー設計において圧倒的な強みを持つMSI。
そして、長年にわたり国内でのBTO(受注生産)カスタマイズの実績と、徹底した検証・サポート体制を持つアプライド。
この強力なタッグにより、「ただの既製品」を販売するのではなく、お客様が動かしたいAIモデルの要件にジャストフィットするMGXサーバーを、構成から柔軟に設計・ご提供できることが、我々の最大の強みです。
推論を加速する2つの「最適解」とGPU比較
「B300」などのハイエンドGPUは水冷設備を要するため、アプライドでは既存の空冷環境に即座に導入でき、ROIを最大化する2つの最適なGPUソリューションをご提案しています。
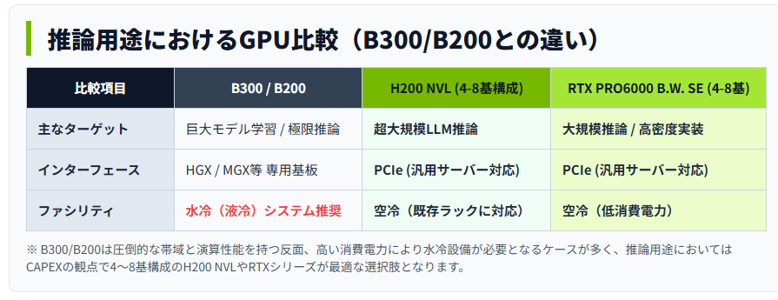
推論用途においては、水冷設備の改修というCAPEX(設備投資)の観点から見ても、H200 NVLやRTX PRO 6000といったPCIe接続・空冷対応のGPUを4〜8基構成で活用するのが、現在の「ベストフィット」と言えます。
NVIDIA H200 NVL
超大規模LLM推論における空冷エンタープライズの標準。
1基あたり141GBの広帯域HBM3eメモリを搭載し、複数基搭載で1TB超のVRAM空間を構築。大掛かりな水冷設備の改修を伴わずに、数千億パラメータの推論を空冷で実現します。
RTX PRO 6000 Blackwell SE
高密度・低コストを両立。
最新Blackwellアーキテクチャでありながら消費電力を抑え、既存ラックの限られた電力枠内でも大規模モデルの推論環境を構築可能です。導入・運用コストを最小化します。
アプライド×MSIによる推論ベストフィット提案
アプライドでは、プレミアムディストリビューターとしてMSI製のMGXアーキテクチャ採用サーバーをベースに、お客様のモデル要件に合わせた最適なインフラをご提案いたします。
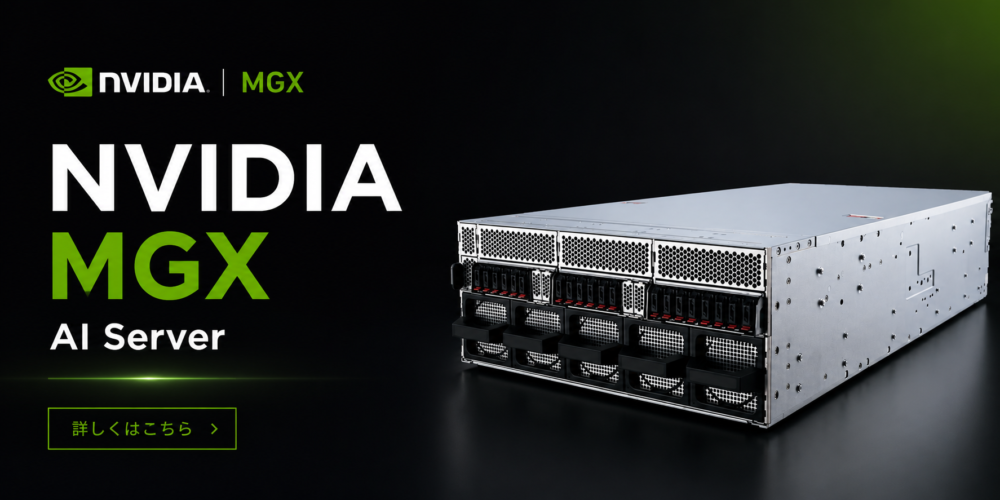
MGXアーキテクチャモデルについては、下記のラインナップもぜひご覧ください。
まとめ|NVIDIA Nemotronで始める次世代のAI活用
生成AIの活用フェーズが「推論」へと移行する中、ただ闇雲にハイエンドGPUを導入するのではなく、「自社の使いたいモデルに対して、いかに無駄なく、空冷のまま効率よく処理させるか」がAIプロジェクト成功の鍵を握ります。
NVIDIA MGXアーキテクチャの優れた柔軟性と、アプライド×MSIのパートナーシップによるカスタマイズ力。そして、H200 NVLやRTX PRO 6000といった空冷対応GPUの組み合わせは、その大きな解決策となります。
推論におけるハードウェアの選定は、ぜひアプライドへご相談ください。
本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。


本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。

