NVIDIA B300 HGX AI Server
「B300 GPU」を1枚のベースボード上に8基統合した、データセンター向けAIサーバープラットフォーム
※掲載製品は参考価格となりますので、最新価格については都度お問い合わせください。
製品紹介
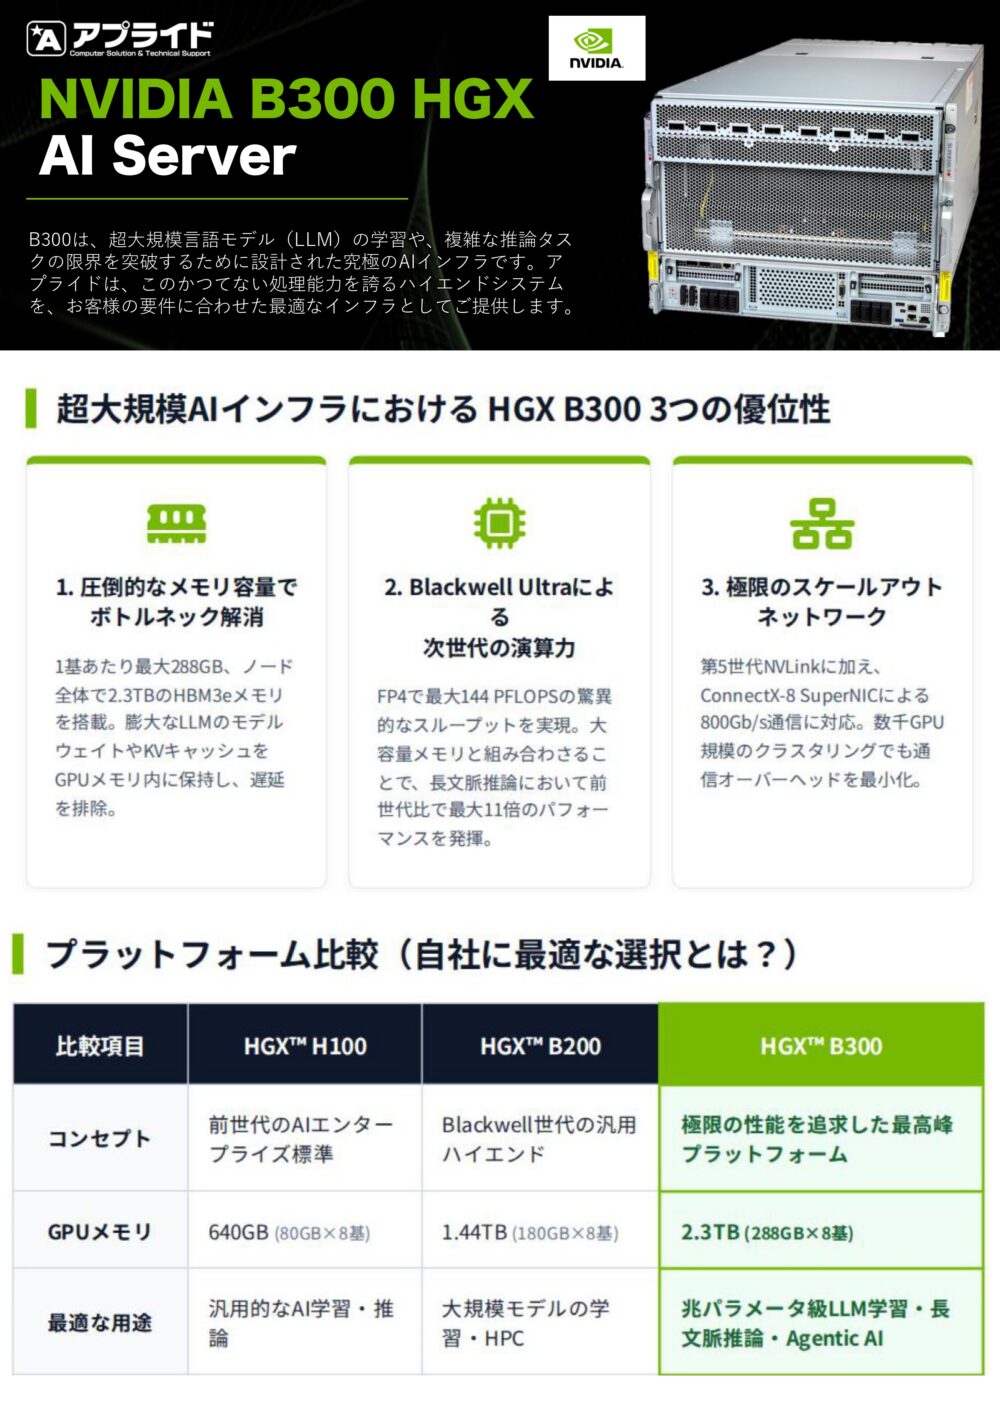
B300は、超大規模言語モデル(LLM)の学習や、複雑な推論タスクの限界を突破するために設計された究極のAIインフラです。アプライドは、このかつてない処理能力を誇るハイエンドシステムを、お客様の要件に合わせた最適なインフラとしてご提供します。
NVIDIA HGX B300は、Blackwell Ultraアーキテクチャを採用したSXMフォームファクタの「B300 GPU」を1枚のベースボード上に8基統合した、データセンター向けAIサーバープラットフォームです。推論スケーリング(Test-Time Scaling)や長大なコンテキストを扱う推論モデル(Reasoning Models)、大規模言語モデル(LLM)の学習・推論向けに設計されており、Dell、Supermicro、HPE、Lenovoなどのサーバーメーカー(OEM)が自社製AIサーバーのコア基板として採用しています。
1. 主要技術仕様(HGX B300 8-GPU ノード)NVIDIA公式データシートおよびプラットフォーム仕様に基づく、HGX B300(8-GPU構成)のスペックは以下の通りです。
搭載GPU: 8x NVIDIA Blackwell Ultra(B300)SXM GPU
GPUメモリ容量: 1基あたり最大 288 GB HBM3e(12-Hi積層)を搭載し、ノード全体で物理容量 約2.3 TB(NVIDIA公式の実行可能メモリ表記で 2.1 TB以上)を確保。
メモリ帯域幅: 1基あたり最大 8 TB/s、ノード合計で 62〜64 TB/s。
演算性能(ノード合計・第5世代Tensorコア):
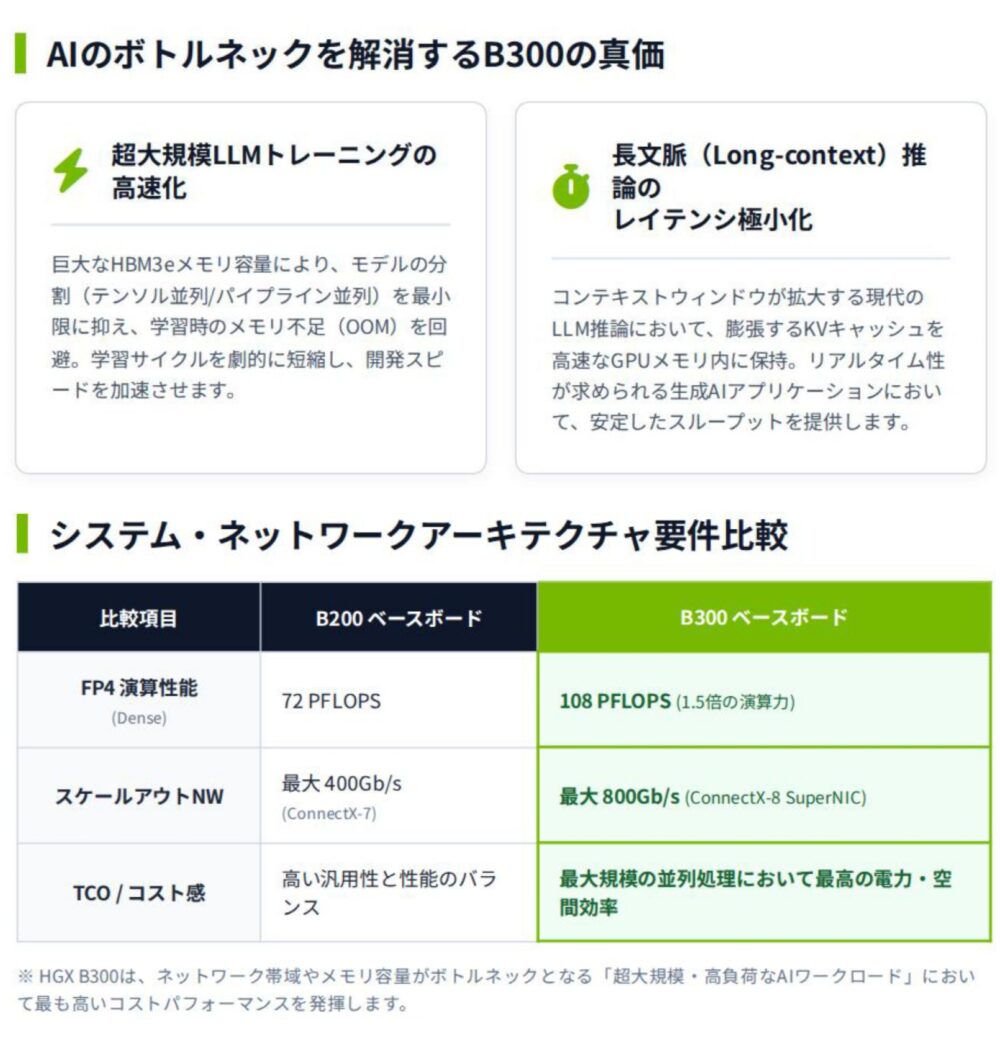
FP4 Tensor演算: 144 PFLOPS(Sparse) / 108 PFLOPS(Dense)
FP8 / FP6 Tensor演算: 72 PFLOPS(Sparse) / 36 PFLOPS(Dense)
ノード内インターコネクト: 第5世代 NVIDIA NVLink および NVLink Switch×2基を搭載。GPUあたり双方向 1.8 TB/s、8基合計で 14.4 TB/s のオール・トゥ・オール通信帯域を提供。
スケールアウト・ネットワーク: 8基の NVIDIA ConnectX-8 SuperNIC に対応し、GPU 1基につき最大 800 Gb/s(NVIDIA Quantum-X800 InfiniBand または Spectrum-X800 Ethernet)の外部通信帯域を実現。ホストインターフェースは PCIe Gen 6(256 GB/s) に対応。
消費電力(TDP)・冷却方式:
GPU TDP: 最大 1,100 W(構成により可変。なお、ラック統合型のGB300 NVL72は最大1,400 W)
システム総消費電力: 約14 kW〜15.1 kW(8-GPUサーバー1台あたり)
冷却方式: 空冷(高背シャーシ)および直接液冷(DLC: Direct Liquid Cooling)の両構成をOEMシステムでサポート。
2. アーキテクチャ上の主な進化点HBM3eメモリ容量の50%拡大(B200比):従来のHGX B200(180〜192 GB/GPU、ノード計約1.44 TB)から、1基あたり最大288 GB(ノード計2.1〜2.3 TB)へと大容量化されています。これにより、推論時のKVキャッシュ(Key-Value Cache)の肥大化や数十万〜100万トークンにおよぶロングコンテキスト処理、数千億パラメータ規模のMoE(Mixture-of-Experts)モデルをノード外へ分割せずにメモリ上に保持できます。
第5世代TensorコアとFP4演算の強化:Blackwell Ultraではマイクロテンソルスケーリングを用いたネイティブFP4(4ビット浮動小数点)演算性能が強化されており、HGX B200(ノード合計72 PFLOPS Dense FP4)と比較して 1.5倍の108 PFLOPS(Dense FP4) を発揮します。また、TransformerのAttention層処理を高速化する専用エンジンが改良され、Hopper世代(H100/H200)比でAttention演算が最大2.5倍高速化されています。
ConnectX-8によるネットワーク帯域の倍増:前世代のConnectX-7(最大400 Gb/s)からConnectX-8(最大800 Gb/s)へ刷新されたことで、マルチノード環境での分散学習(All-Reduce通信)や、大規模MoEモデルにおけるノード間のExpertルーティング時の通信ボトルネックが大幅に軽減されています。実ワークロードでの性能向上:NVIDIAの公式ベンチマークによると、HGX H100と比較して、大規模推論モデル「DeepSeek-R1」の学習速度で 最大2.6倍、Llama 3.1 405Bの推論スループットで 最大11倍 の性能向上が報告されています。
仕様・スペック
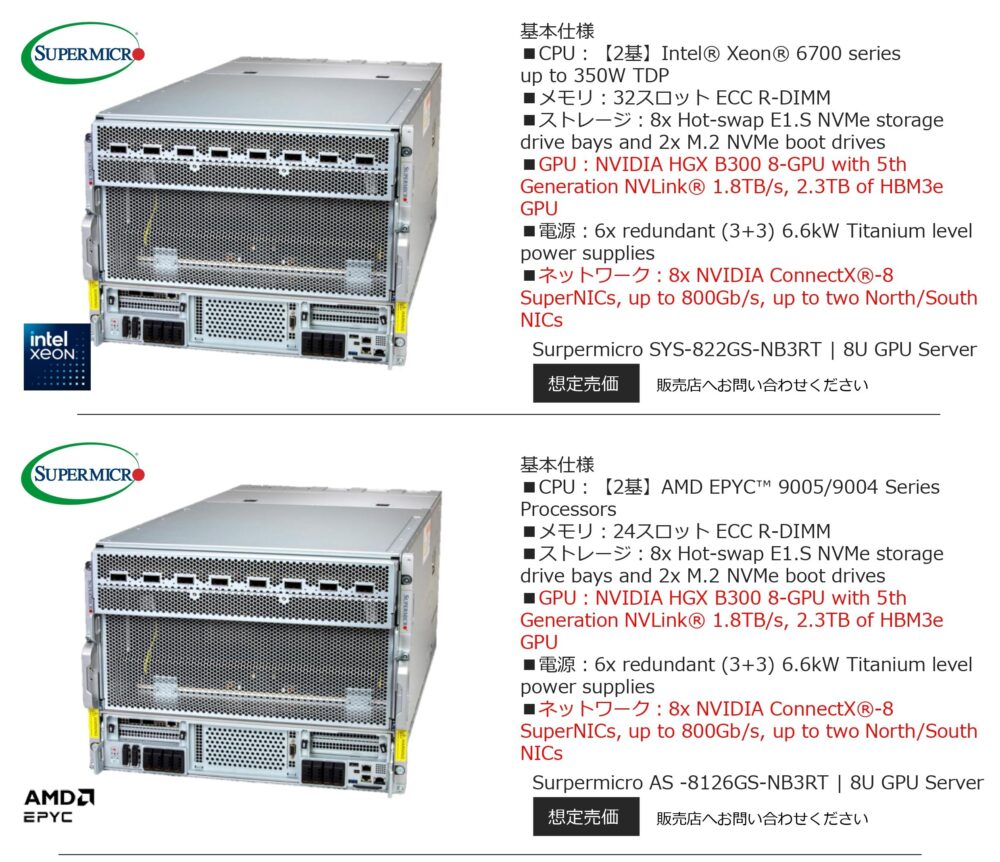
❶Surpermicro SYS-822GS-NB3RT | 8U GPU Server
基本仕様
■CPU:【2基】Intel® Xeon® 6700 series up to 350W TDP
■メモリ:32スロット ECC R-DIMM
■ストレージ:8x Hot-swap E1.S NVMe storage drive bays and 2x M.2 NVMe boot drives
■GPU:NVIDIA HGX B300 8-GPU with 5th Generation NVLink® 1.8TB/s, 2.3TB of HBM3e GPU
■電源:6x redundant (3+3) 6.6kW Titanium level power supplies
■ネットワーク:8x NVIDIA ConnectX®-8 SuperNICs, up to 800Gb/s, up to two North/South NICs
❷Surpermicro AS -8126GS-NB3RT | 8U GPU Server
基本仕様
■CPU:【2基】AMD EPYC 9005/9004 Series Processors
■メモリ:24スロット ECC R-DIMM
■ストレージ:8x Hot-swap E1.S NVMe storage drive bays and 2x M.2 NVMe boot drives
■GPU:NVIDIA HGX B300 8-GPU with 5th Generation NVLink® 1.8TB/s, 2.3TB of HBM3e GPU
■電源:6x redundant (3+3) 6.6kW Titanium level power supplies
■ネットワーク:8x NVIDIA ConnectX®-8 SuperNICs, up to 800Gb/s, up to two North/South NICs
基本仕様
■CPU:【2基】Intel® Xeon® 6700 series up to 350W TDP
■メモリ:32スロット ECC R-DIMM
■ストレージ:8x Hot-swap E1.S NVMe storage drive bays and 2x M.2 NVMe boot drives
■GPU:NVIDIA HGX B300 8-GPU with 5th Generation NVLink® 1.8TB/s, 2.3TB of HBM3e GPU
■電源:6x redundant (3+3) 6.6kW Titanium level power supplies
■ネットワーク:8x NVIDIA ConnectX®-8 SuperNICs, up to 800Gb/s, up to two North/South NICs
❷Surpermicro AS -8126GS-NB3RT | 8U GPU Server
基本仕様
■CPU:【2基】AMD EPYC 9005/9004 Series Processors
■メモリ:24スロット ECC R-DIMM
■ストレージ:8x Hot-swap E1.S NVMe storage drive bays and 2x M.2 NVMe boot drives
■GPU:NVIDIA HGX B300 8-GPU with 5th Generation NVLink® 1.8TB/s, 2.3TB of HBM3e GPU
■電源:6x redundant (3+3) 6.6kW Titanium level power supplies
■ネットワーク:8x NVIDIA ConnectX®-8 SuperNICs, up to 800Gb/s, up to two North/South NICs
用途・実績例
1. 主な用途(ターゲットワークロード)
① 推論モデル(Reasoning Models)とTest-Time ScalingDeepSeek-R1やOpenAI o1/o3系、GPT-OSS-120Bのように、回答生成前に長い思考連鎖(Chain-of-Thought)を内部で反復生成する推論モデルに用いられます。
理由: 思考ステップが長くなるほどKVキャッシュ(Key-Value Cache)が膨大になりメモリ帯域と容量を圧迫しますが、1基あたり288 GBのVRAMと第5世代TensorコアのネイティブFP4(NVFP4)演算を組み合わせることで、推論精度を維持したまま高い同時接続数(バッチサイズ)と低遅延を両立できます。
② 自律型AIエージェント(Agentic AI)の運用と強化学習複数のツール呼び出しやコード生成、マルチステップの推論を自律的に行うAIエージェントの本番稼働および環境フリー強化学習(RL)に活用されています。
理由: エージェント処理では1リクエストあたり数万〜数十万トークンのコンテキストを保持しながら高速に応答する必要があるため、HGX B200比で1.5倍のメモリ容量(ノード計2.1 TB以上)と、ConnectX-8(800 Gb/s×8)による高速なノード間通信が直接的な優位性となります。
③ 超巨大LLM・MoEモデルの単一ノード推論およびファインチューニング1,000億(100B)〜4,050億(405B)パラメータ規模の大規模言語モデルや、Mixture-of-Experts(MoE)モデルの学習・推論基盤として使われます。
理由: たとえば70Bクラスのモデルであれば1基のB300(288 GB)上に非量子化(FP16)のまま格納してなお100 GB以上のKVキャッシュ領域を残すことができ、405B〜671Bクラスの巨大モデルでも1ノード(8基)内に収めてノード間通信のオーバーヘッドなしに高速処理できます。
【重要】不向きな用途(FP64 科学技術計算・HPC):HGX B300はAI演算(FP4/FP8/FP16)に特化してダイ面積を割り振っており、倍精度浮動小数点演算(FP64)性能はノード合計で約10 TFLOPS(HGX B200は約296 TFLOPS)に抑えられています。気象予測、流体解析、創薬の分子動力学計算など、厳密なFP64精度を要する従来型スパコン・HPC用途にはHGX H200またはHGX B200が適しています。