
NVIDIA Vera Rubinとは?Blackwellとの違いと製造業や研究開発での活用を解説
NVIDIA Vera Rubin 技術コラム | 2026年11月版
みなさんこんにちは。アプライド広域システム営業部です。
製造業や研究開発の現場では、生成AIによる技術文書の検索、画像を使った品質管理、シミュレーションとAIの連携など、GPUを活用する場面が広がっています。
扱うモデルやデータが大きくなるほど、計算能力に加えて、データを保持するメモリや、複数のGPUが情報をやり取りする速度も重要になります。
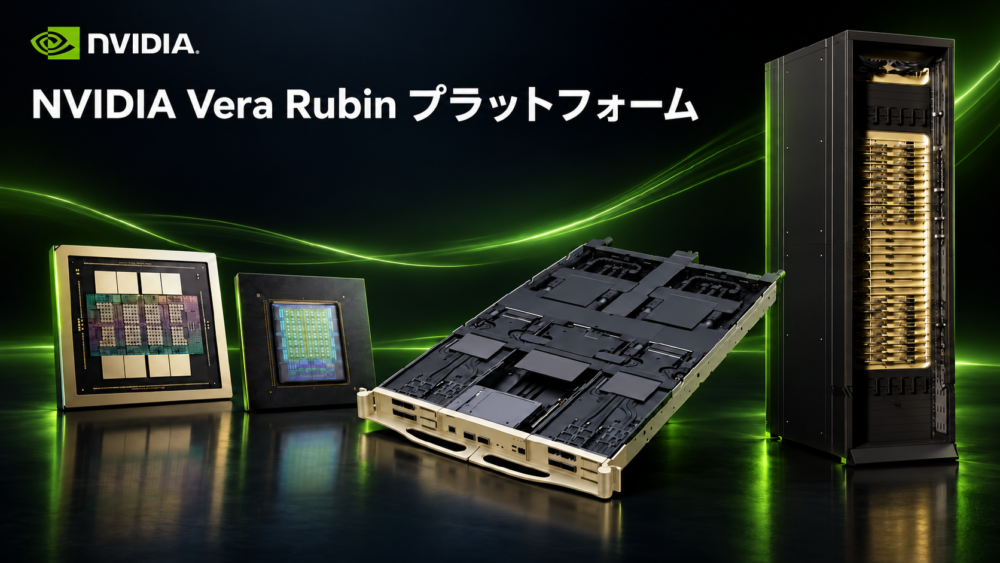
こうした処理を支える新たな基盤が、NVIDIAの「Vera Rubin」です。CPU、GPU、メモリ、通信、冷却をシステム全体で設計し、大規模なAI処理の効率を高めることを目指しています。
本記事では、Hopper・Blackwellからの進化をたどりながら、製造業・研究開発での活用と、各メーカーの製品を紹介します。
Vera RubinはCPUとGPUを軸とした計算プラットフォーム
まず、名称を整理しましょう。「Vera」はCPU、「Rubin」はGPUの名称です。Vera Rubinは、これらに高速通信やネットワークなどを組み合わせたプラットフォームを指します。
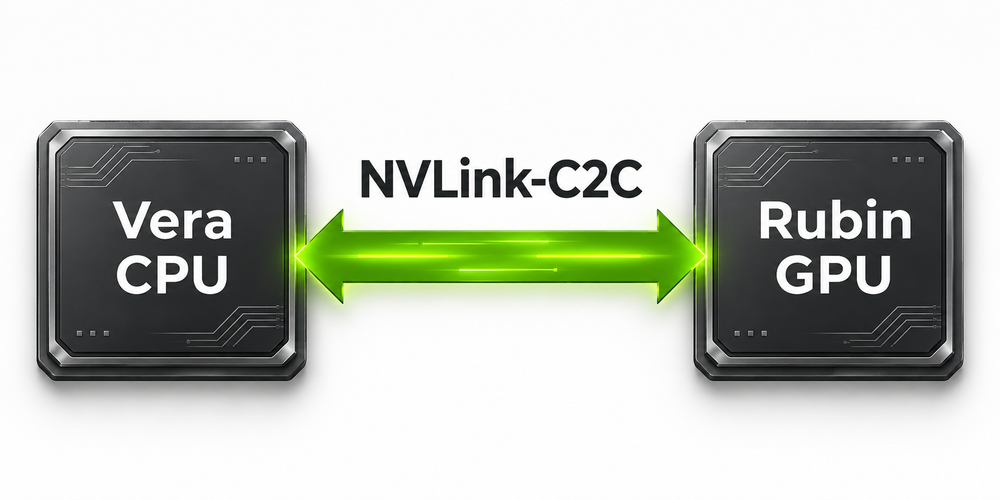
CPUはデータの前処理やプログラムの実行制御などを担い、GPUはAIの学習・推論で使う大量の計算を担当します。Vera CPUとRubin GPUを組み合わせた構成では、両者を「NVLink-C2C」という高速な接続で結び、CPUとGPUの間でデータを効率よく受け渡します。
たとえば、複数の資料を調べ、外部ツールを使いながら回答を組み立てるAIエージェントでは、GPUの計算に加えて、CPU側で行う処理も増えます。Vera Rubinは、こうした一連の作業をシステムとして支える設計になっています。
HopperからBlackwellへ そしてRubinへ
世代の違いは、GPUの型番と、CPUを組み合わせたシステムの名称を整理すると理解しやすくなります。
| 比較項目 | Hopper | Blackwell | Rubin |
| 代表的なGPU | H100・H200 | B200・B300 B300はBlackwell Ultra | Rubin GPU |
| CPUとの統合構成 | GH200 Grace CPU+Hopper GPU | GB200・GB300 Grace CPU+Blackwell GPU | Vera Rubin Vera CPU+Rubin GPU |
| 代表的なシステム | HGX H100・H200など | HGX B200・B300 GB200・GB300 NVL72 | HGX Rubin NVL8 Vera Rubin NVL72 |
Hopper世代のH100・H200は、AIと科学技術計算の双方で用いられるGPUです。
Blackwell世代では、AI向けの低精度演算や大容量メモリの活用が進み、GB200・GB300 NVL72のようなラック規模の構成も展開されています。
Rubin世代はその流れを引き継ぎ、HBM4メモリや第6世代NVLinkなどによって、大規模なAI処理を支える基盤を更新しています。
H200・B200・B300の仕様や公開ベンチマークについては、関連記事「NVIDIA HGX B300は何が進化したのか?H200・B200比較と公開レビューで見る大規模AI基盤」でも詳しく解説しています。
Blackwellからの変化はメモリと通信とAI演算に注目
HBM4メモリで大量のデータを計算へ届ける
Rubin GPUは、GPUの近くに配置する高速メモリとしてHBM4を採用しています。メモリを見る際には、「容量」と「帯域」を押さえると、用途との関係がわかりやすくなります。
容量は、モデルや処理中のデータをどれだけ保持できるかという大きさです。帯域は、保持したデータをどれだけ速く読み書きできるかを表します。本棚に例えると、容量は本を置ける量、帯域は本を出し入れする速さです。
LLMでは、モデルの重みに加えて、会話の文脈を再利用するためのKVキャッシュなどにもメモリを使います。長い技術文書を扱う場合や、複数の利用者が同時にAIを使う場合には、こうした領域を含めて容量を見積もり、データの読み出しが処理を待たせない構成を考えます。
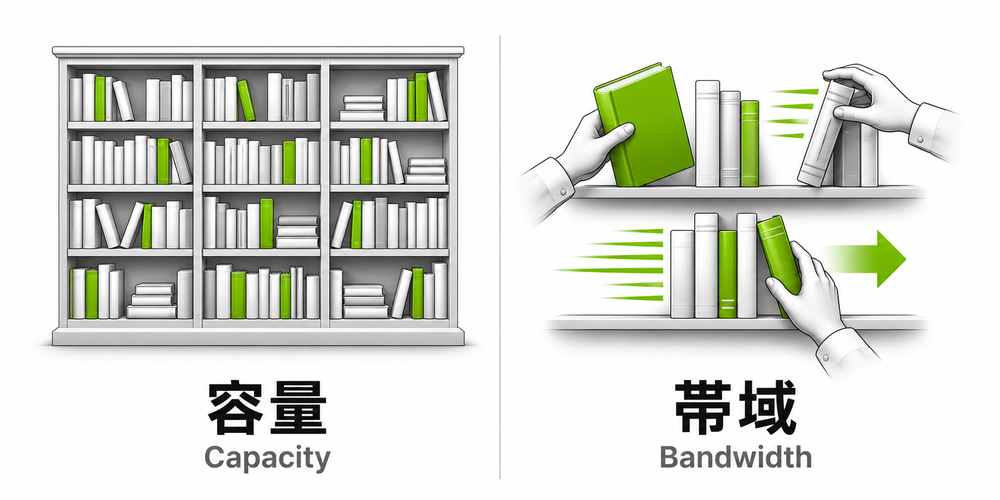
※メモリ容量は保持できる量、メモリ帯域は読み書きできる速さ。本棚の大きさでメモリ容量を、本の出し入れでメモリ帯域を表した図
◆第6世代NVLinkで複数のGPUを高速に連携
大きなAIモデルを複数のGPUに分けて処理すると、GPU同士で計算結果などを交換する必要があります。
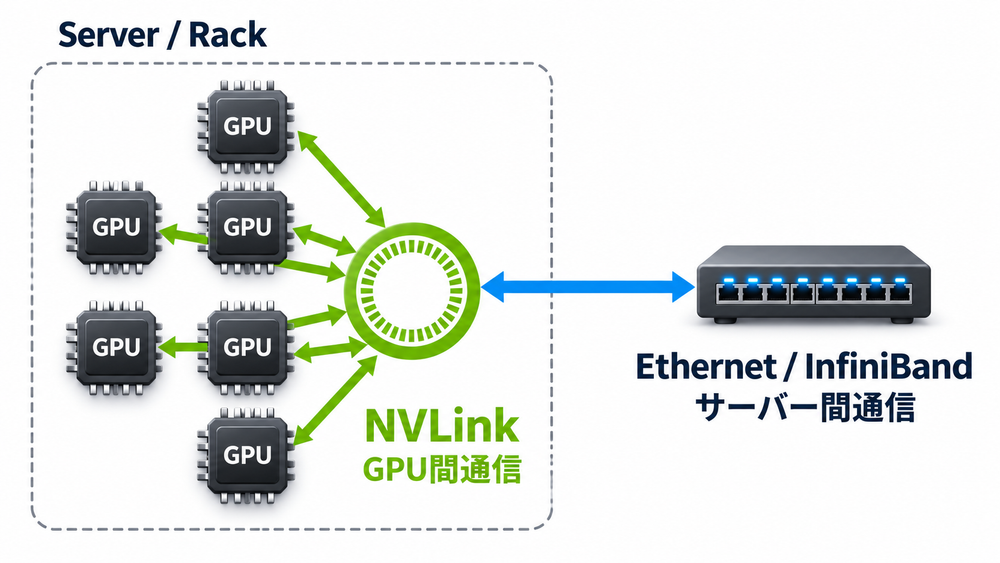
Rubin世代は、第6世代NVLinkによって、このGPU間通信を強化しています。GPU同士の連携を担うのがNVLink、サーバーやラックをまたぐシステムの拡張を支えるのがInfiniBandやEthernetです。必要なGPU数とデータ交換の量に合わせて通信経路を設計することで、複数GPUの計算能力を生かしやすくなります。
◆AIに適した演算方式で処理効率を高める
Rubinでは、NVFP4などの低精度形式を活用したAI演算も強化されています。扱う数値を少ないビット数で表すことで、メモリ使用量や計算の負担を抑え、多くの処理を効率よく実行する考え方です。
実際の導入では、対象モデルの回答品質や認識精度を評価しながら、対応するソフトウェアと演算方式を選びます。処理速度、同時利用者数、必要な精度をそろえて評価することが、自社の用途に合った性能を判断するポイントです。
HGX Rubin NVL8とVera Rubin NVL72の違い
Rubinを搭載する製品は、8GPUを組み合わせるサーバー構成と、72GPUを高速に接続するラック規模の構成を軸に整理できます。
| 比較項目 | HGX Rubin NVL8 | Vera Rubin NVL72 |
| GPU数 | 8基 | 72基 |
| CPU構成 | 製品によりx86 CPUまたはVera CPU | Vera CPU 36基 |
| 構成の単位 | 8GPUサーバー | ラック全体 |
| 検討の目安 | 8GPUを単位に導入や拡張を計画する用途 | 大規模モデルを多数のGPUで密に連携して処理する用途 |
HGX Rubin NVL8では、Vera CPUと組み合わせる構成に加え、IntelやAMDのx86 CPUを採用するメーカー製品も展開されています。一方、Vera Rubin NVL72は、72基のRubin GPUと36基のVera CPUをラック全体で統合し、NVLinkの高速な通信基盤を大きな規模で利用します。
選定ではGPU数に加えて、どの範囲のGPUがNVLinkでつながるかにも注目します。8GPUサーバーを9台並べる構成とNVL72では、同じ72GPUでも接続構成が異なるため、モデルの分割方法や通信量に合わせた検討が必要です。
製造業と研究開発ではどのように活用できるか
製造業・研究開発に当てはめると、次のような用途でRubin世代のシステムを検討できます。以下は用途を整理した例です。必要なGPU数や構成は、モデルの規模と利用量に合わせて決めます。
| 用途 | 利用イメージ | 構成を決める主な要素 |
| 技術文書の検索と回答支援 | 設計仕様書、作業手順書、過去の報告書を参照して回答する | モデル規模、入力文の長さ、同時利用者数 |
| 画像と文章を扱うAI | 製品画像と検査記録を組み合わせ、状態の説明や確認を支援する | 画像解像度、入力数、応答時間 |
| AIモデルの学習と調整 | 自社の画像や技術データに合わせてモデルを学習・調整する | データ量、学習方法、許容する学習時間 |
| シミュレーションとAIの連携 | 解析結果を学習し、条件を変えたときの結果を予測する | 予測誤差、適用する条件範囲、学習データ量 |
◆サロゲートモデルで設計候補を効率よく探索
研究開発で注目したいのが、サロゲートモデル(代理モデル)です。熱や流体などのシミュレーション結果をAIに学習させ、形状や条件を変えた場合の結果を近似的に予測します。
たとえば、冷却部品の形状を検討する際、AIで多くの候補を素早く比較し、有望な案を詳細な解析や実験で確かめる使い方が考えられます。探索と検証を組み合わせることで、設計の試行回数を増やしやすくなります。NVIDIAもPhysicsNeMoを通じて、流体、構造、電磁界などの領域で物理シミュレーションとAIを組み合わせる開発基盤を提供しています。
◆科学技術計算ではFP64とソフトウェア対応を確認
従来のCAEや科学技術計算では、倍精度のFP64など、高い数値精度が必要になる処理があります。HopperのH100・H200はFP64演算やFP64 Tensor Coreを備え、BlackwellではB200とB300でFP64の仕様が異なります。
RubinもFP64演算に対応し、さらにTensor Coreを活用して倍精度の行列演算を高速化する方式が示されています。これは低精度の演算を組み合わせて倍精度計算を実現する方式で、対応するライブラリや計算内容に応じて活用します。
そのため、解析用途ではソルバーのGPU対応、必要な精度、計算の種類を確かめ、実際に利用する問題で評価することが有効です。AIの学習・推論と従来の解析を組み合わせる場合も、それぞれの処理に合う構成を選ぶことで、研究開発全体の効率向上につなげられます。
高密度なGPUシステムは冷却と電源まで含めて設計
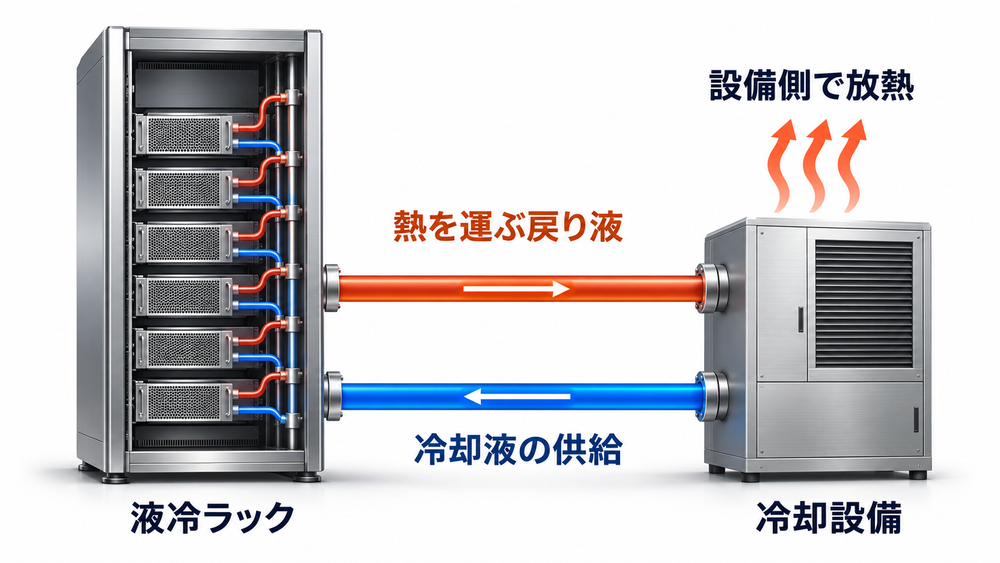
Rubin世代では、液冷を採用した高密度な製品が各社から紹介されています。GPUなどに取り付けたコールドプレートで熱を冷却液へ移し、CDU(冷却液の循環や熱交換を担う装置)などを介して設備側へ運びます。
HGX Rubin NVL8には、8GPUを2Uの筐体に搭載する製品もあります。2Uは高さの規格で、必要な電源や冷却能力は製品ごとに異なります。たとえば、GIGABYTEやASRock Rackの紹介機種は、液冷に加えて54V DCバスバー給電を採用しています。
導入計画では、サーバーの設置寸法、ラックの耐荷重、受電容量、冷却液の供給条件、保守スペースまでを一緒に確認します。設備側の条件を早い段階で整理しておくと、設置場所や構成の選定を進めやすくなります。
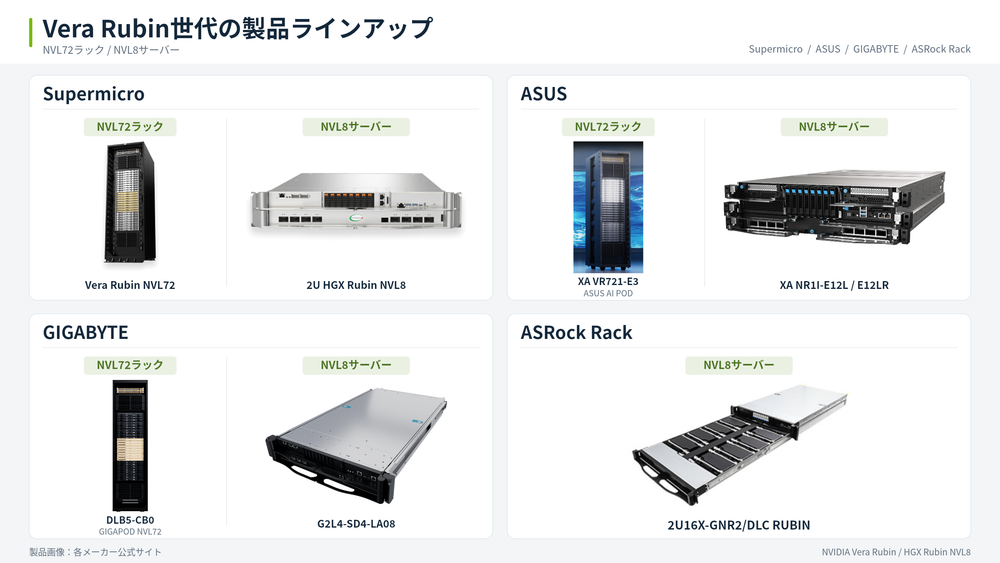
Supermicro ASUS GIGABYTE ASRock Rackの製品例
ここからは、メーカーが公式に紹介している製品を見てみましょう。NVL72ラックとNVL8サーバーの両方を展開するメーカーに加え、2UのNVL8サーバーなど、具体的な形状や冷却方式が公開されています。
| メーカー | 紹介製品 | 主な特徴 |
| Supermicro | Vera Rubin NVL72 2U HGX Rubin NVL8 | 液冷ラックから8GPUサーバーまで展開。電源や冷却設備を含めた構成を提案 |
| ASUS | XA VR721-E3 XA NR1I-E12L/E12LR | NVL72のAI PODとNVL8サーバー。NVL8ではハイブリッド冷却と完全液冷のモデルを紹介 |
| GIGABYTE | Vera Rubin NVL72 G2L4-SD4-LA08 | ラック構成に加え、CPUとGPUを直接液冷する2UのNVL8サーバーを紹介 |
| ASRock Rack | 2U16X-GNR2/DLC RUBIN | 完全液冷の2U NVL8サーバー。Intel Xeonとの組み合わせと54V DCバスバー給電に対応 |
※各メーカーが紹介するVera Rubin NVL72とHGX Rubin NVL8の製品例
提供状況について、Supermicroは2026年9月23日にVera Rubin NVL72ラックの出荷開始を発表しています。一方、GIGABYTEのG2L4-SD4-LA08は、2026年11月3日時点で公式ページに「To be released」と掲載されています。ASUS・ASRock Rackも製品情報を公開しており、国内での受注可否、納入時期、選択できる構成は製品ごとに確認します。
Vera Rubinを理解することから次の計算基盤選びへ
Vera Rubinの特徴は、GPUの演算能力と、データを保持・移動する仕組みを、システム全体で強化している点にあります。HBM4メモリ、第6世代NVLink、Vera CPUとの連携を通じて、大規模モデルや多数のAI処理を支える構成を目指しています。
製造業・研究開発で導入を考える際には、「どの業務で使うか」「どの程度のモデルやデータを扱うか」「何人が同時に使うか」「どこに設置するか」を整理することが出発点になります。現在利用できるHopper・Blackwell世代の製品も含め、用途と導入時期に合う計算基盤を選んでいきましょう。
アプライドでは、製造業・研究開発に向けたAI・HPC環境の構成をご相談いただけます。生成AI、画像解析、シミュレーションなど、予定している用途と設置環境をお聞かせください。GPUサーバーや周辺システムの検討をお手伝いします。
本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。



本記事でお伝えした内容に加え、関連するテーマを1冊にまとめたホワイトペーパーをご用意しました。
以下のボタンより、現場ですぐに使えるノウハウをお受け取りください。

