
クラウドコストや
待ち時間を抑えたい
継続課金・共有リソースの待機
 NVIDIA.
DGX STATION
on NVIDIA DGX Station architecture
10月下旬より順次出荷開始予定
AI DEVELOPMENT CHALLENGES
継続課金・共有リソースの待機
セキュリティ・コンプライアンス
大規模LLM・VLMのメモリ不足
生成AIの活用が広がる一方、製造業や研究機関では、
といった課題が顕在化しています。
特に、大規模言語モデルのLLMや、画像と文章を組み合わせて処理するVLMは大型化が進んでいます。一般的な48GBや96GBクラスのGPUでは、モデル全体を読み込めないケースも少なくありません。
こうした課題に対する新たな選択肢が、748GBのコヒーレントメモリを搭載した「MSI XpertStation WS300」です。
本記事では、WS300の特徴と、どのようなAI開発に適しているのかを分かりやすく解説します。
SPECIFICATIONS
02 / LINEUP
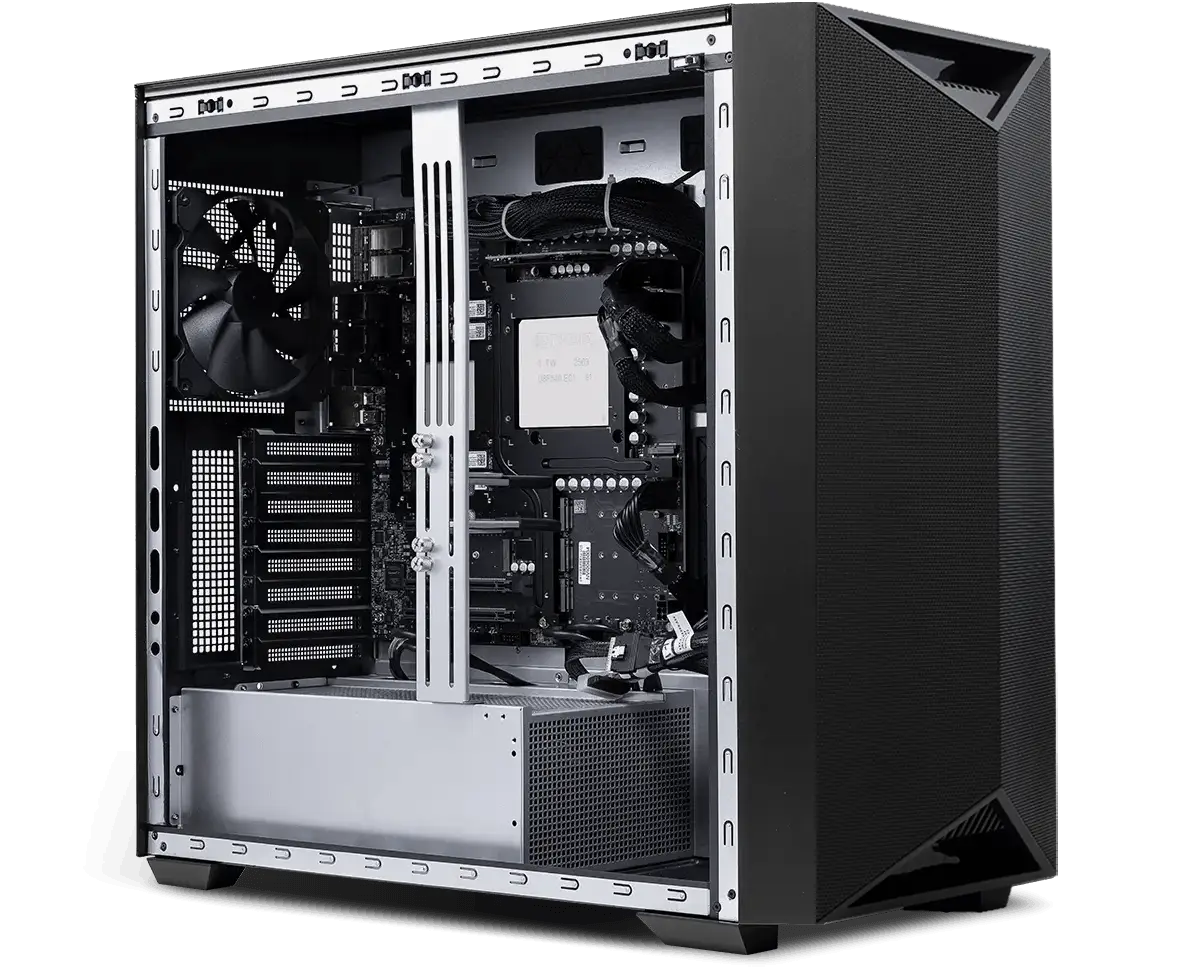
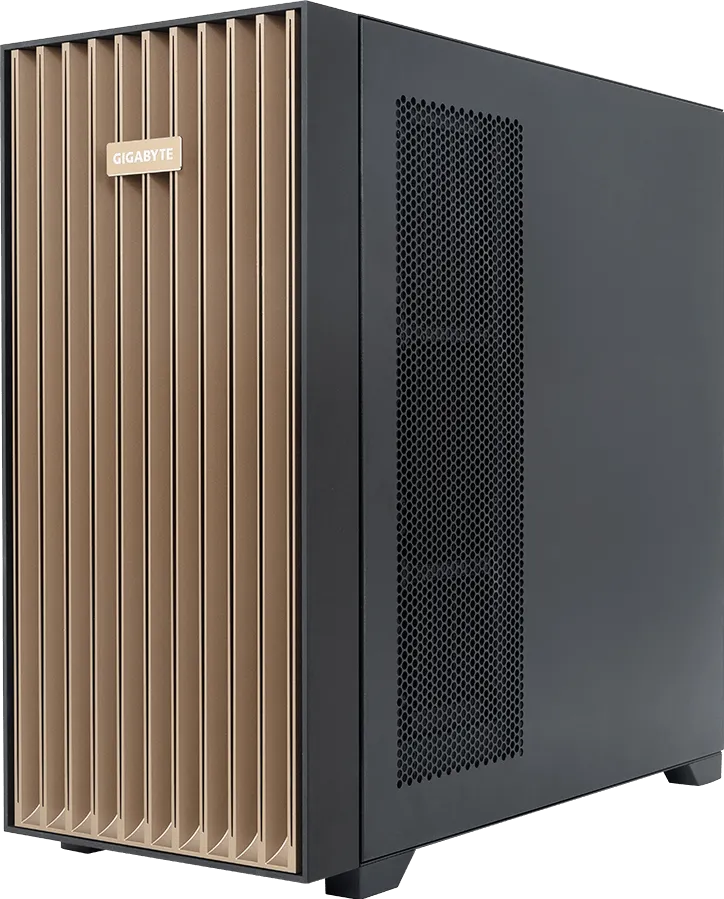
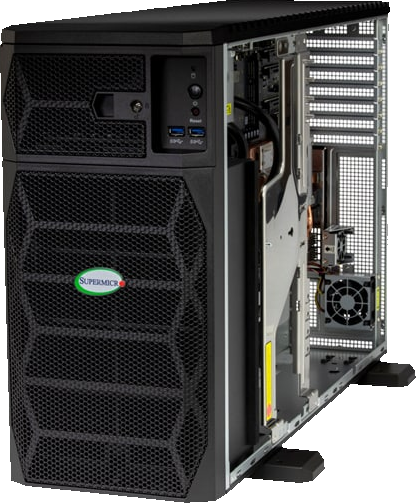
演算基盤が共通だからこそ、選定差は納期・筐体・保守。導入条件に合うメーカーをお選びください。
03 / COMPARISON
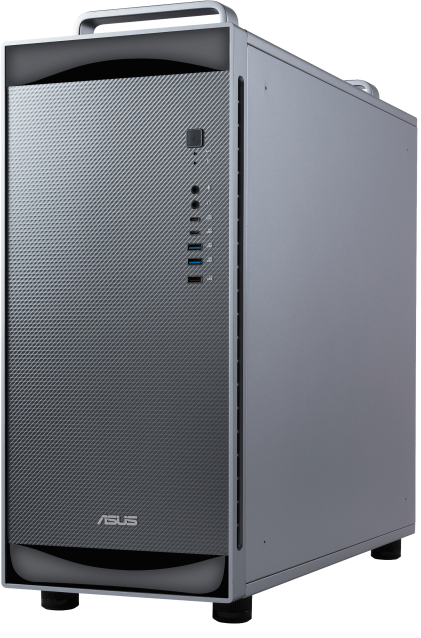
設置場所・受電環境・保守まで、導入後を見据えて選定。
| 比較項目 | ASUSET900N G3 | GIGABYTEW775-V10-L01 | MSIXpertStation WS300 | SUPERMICROSuper AI Station |
|---|---|---|---|---|
| 納期目安 | 約35週間 | 確認中 | 10月下旬予定 | 確認中 |
| 外形寸法 幅×奥行×高さ |
232×584×565mm | 245×500.4×531mm | 247.8×582.7×527.9mm | 218.4×701×454.7mm |
| 重量 | 27kg | 29.2kg | 約26kg(本体) 約32kg(梱包時) ※参考値 |
約40kg |
| 電源 | 1600W Titanium | 1600W Platinum | 1600W Titanium | 1600W Titanium Level |
| OS | Ubuntuベース NVIDIA AI Tools |
Ubuntuベース NVIDIA AI Tools |
Ubuntuベース NVIDIA AI Tools |
Ubuntuベース NVIDIA AI Tools |
| 保守 | 3年オンサイト | 3年センドバック | 3年(オンサイト選択可) | 1~3年・オンサイト選択可 |
※ 仕様・納期・保守内容は予告なく変更される場合があります。正式なお見積り時に最新情報をご案内します。
COHERENT MEMORY
Grace CPUとBlackwell Ultra GPUをNVLink-C2Cで接続。単一ノードで扱えるモデルの選択肢を広げます。
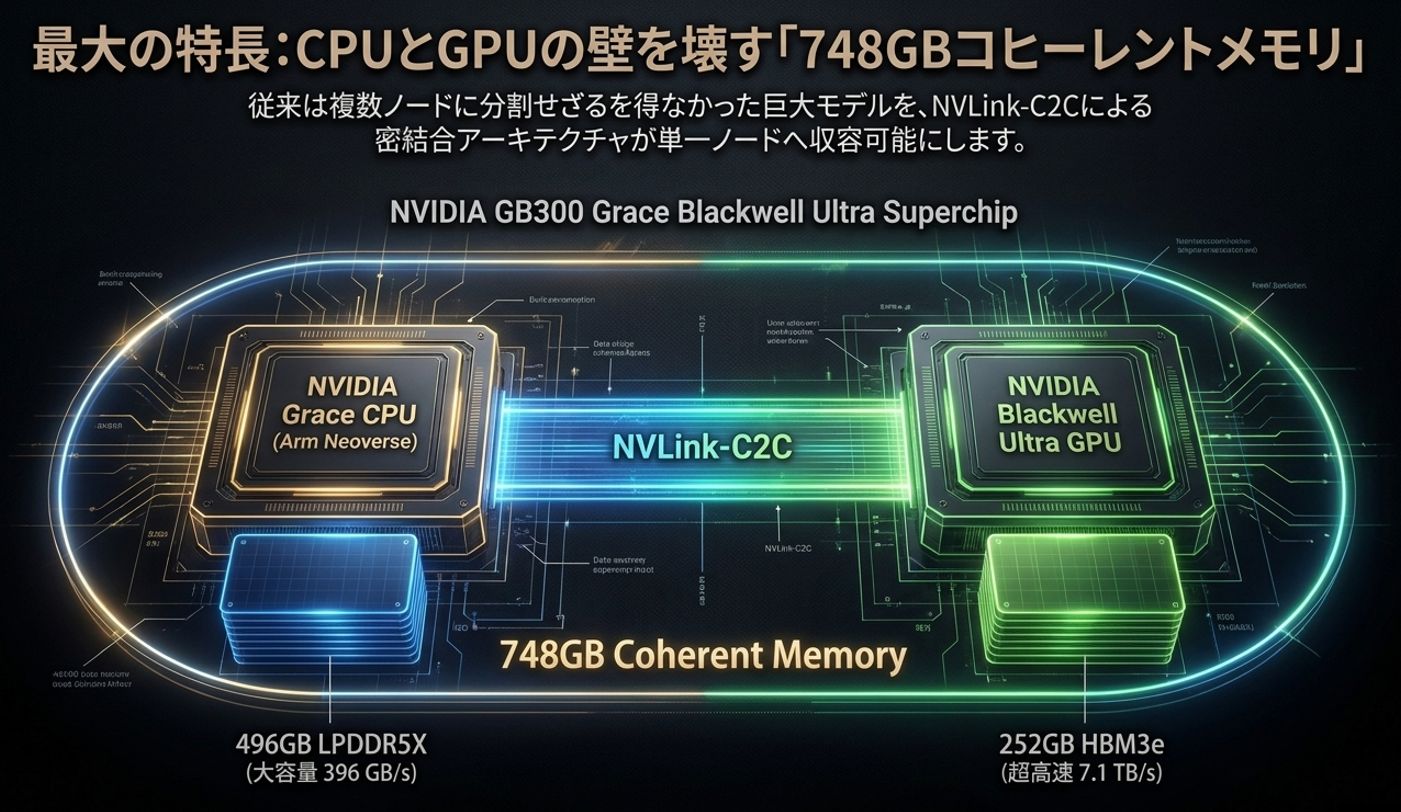
最大帯域 7.1TB/s。高速処理の中心となるGPU側メモリ。
帯域 396GB/s。大規模モデルの収容領域を拡張。
従来は収まらなかったモデルを単一ノードで検証できる可能性。
※748GBすべてがHBM3eと同一速度で動作するわけではありません。252GBを超えてCPU側メモリを利用する場合は、容量と速度のトレードオフがあります。
MODEL CAPACITY GUIDE
必要メモリはパラメータ数と精度で大きく変わります。まずはモデル重みの概算から、検討の目安をつくります。
| 代表的なモデル | 総パラメータ数 | モデル構造 | BF16概算 | FP8概算 | 4bit概算 |
|---|---|---|---|---|---|
| Gemma 3 27B | 27B | Dense | 約54GB | 約27GB | 約14GB |
| gpt-oss-120b | 117B | MoE / 5.1B稼働 | 約234GB | 約117GB | 約59GB |
| Qwen3-235B-A22B | 235B | MoE / 22B稼働 | 約470GB | 約235GB | 約118GB |
| DeepSeek-R1 | 671B | MoE / 37B稼働 | 約1.34TB | 約671GB | 約336GB |
※BF16=約2バイト、FP8=約1バイト、4bit=約0.5バイト/パラメータとして算出したモデル重みのみの概算です。実際にはKVキャッシュ、推論エンジン、量子化情報、演算用ワークスペースなどの追加メモリが必要です。特定モデルの動作を保証するものではありません。
GPU側HBM3eへ収まり、高速に処理しやすい領域。
CPU側メモリも活用し、数百B級モデルを単一ノードで検証。
量子化・モデル分割・複数ノード・GPUサーバーを検討。
USE CASES
巨大なモデルを読み込むだけでなく、モデル本体以外にもメモリを使う実務環境で力を発揮します。
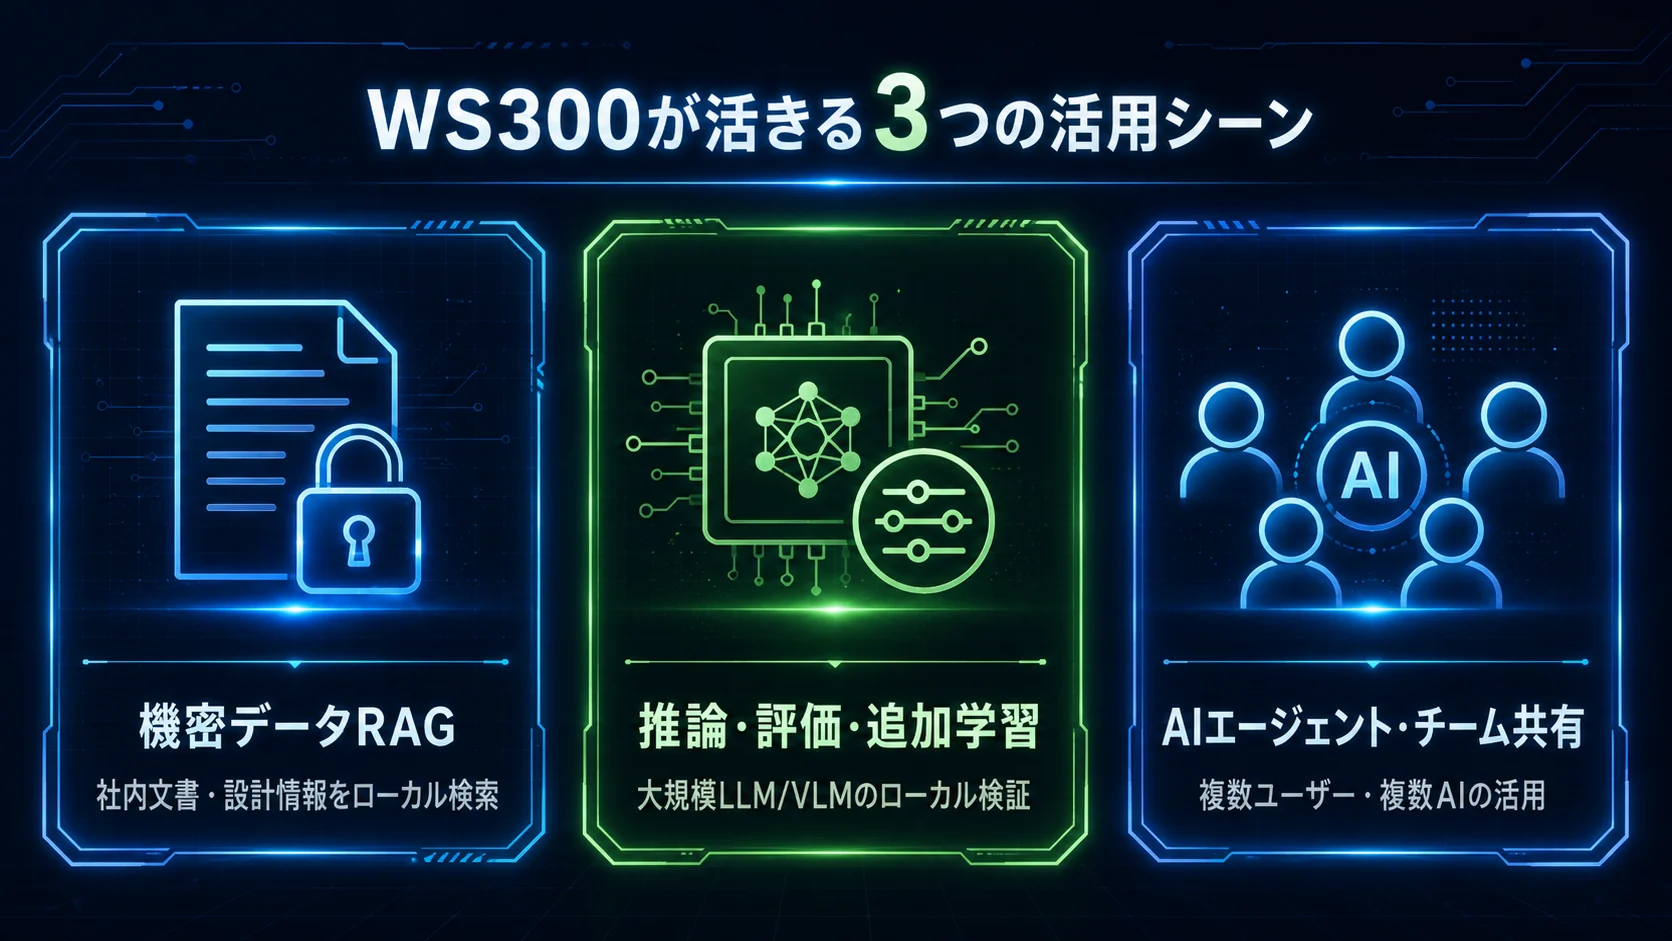
技術文書、設計情報、品質記録、研究データなどを外部へ送信せず、社内で検索・回答する基盤として活用できます。
複数のLLM・VLMを比較し、自社の専門データに合わせて調整。大規模モデルの検証サイクルをローカルで回せます。
文書検索や画像認識など複数AIの組み合わせ、長コンテキスト処理、複数ユーザーの同時利用に備えられます。
XPERTSTATION WS300 USE CASES
ここでは、XpertStation WS300 がAI開発の現場で具体的にどのように活用されるか、主要なユースケースを解説します。
企業が自社データを活用した独自の大規模言語モデル(LLM)を開発・運用するニーズは高まっています。しかし、AI開発を行うには大きなモデルを扱うには膨大な計算資源が必要となってきています。
XpertStation WS300 は、これまでデータセンターでしか利用できなかったGrace Blackwell アーキテクチャを搭載しており、データセンターレベルのパフォーマンスを実現することができます。これにより、研究開発から実運用までのサイクルを、デスクサイドの環境で完結させることが可能になります。
創薬の分子シミュレーションやゲノム解析といった最先端の研究分野では、スーパーコンピュータの利用が不可欠です。しかし、共用のスパコンでは利用申請や待機時間が発生するため、研究の進行やトライアンドエラーを遅らせる一因となる場合があります。
XpertStation WS300 をラボ単位で導入することにより、研究者はスパコン級の計算リソースを占有し、必要な時に即座に実行できるようになります。これにより、申請や待機に伴う時間的制約が解消され、新薬開発や治療法発見に至る研究サイクルが大幅に加速されると期待されます。
製造業の生産ライン最適化や自動運転開発などにおいて、現実世界を忠実に再現した「デジタルツイン」の活用が重要視されています。しかし、シミュレーションの忠実度(フィデリティ)を上げるほど計算負荷は増大し、リアルタイムでの再現は技術的な課題の一つです。
XpertStation WS300 の高い計算能力を用いることで、工場全体や都市規模といった大規模なシミュレーションであっても、リアルタイムでの実行が可能になります。これにより、物理的な試作や実証実験の前に、仮想空間上で安全性や効率性を徹底的に事前検証する体制を構築できます。
株価や為替といったリアルタイム性の高い市場データを扱う金融サービスでは、AIモデルの処理速度が極めて重要となります。リスク分析やクレジットカードの不正検知など、ミリ秒単位の遅延が大きな損失に繋がりかねない領域では、高速な推論能力が不可欠です。
XpertStation WS300 は、膨大な金融データを高速に処理する能力を備えており、複雑で高精度なAIモデルの学習時間を短縮します。さらに本番環境においても、リアルタイムで流入するデータを分析し、不正の兆候などを即座に検知することが可能です。
RIGHT SYSTEM, RIGHT WORKLOAD
WS300は万能型ワークステーションではありません。扱うモデルと運用条件から、最適な基盤を選ぶことが重要です。
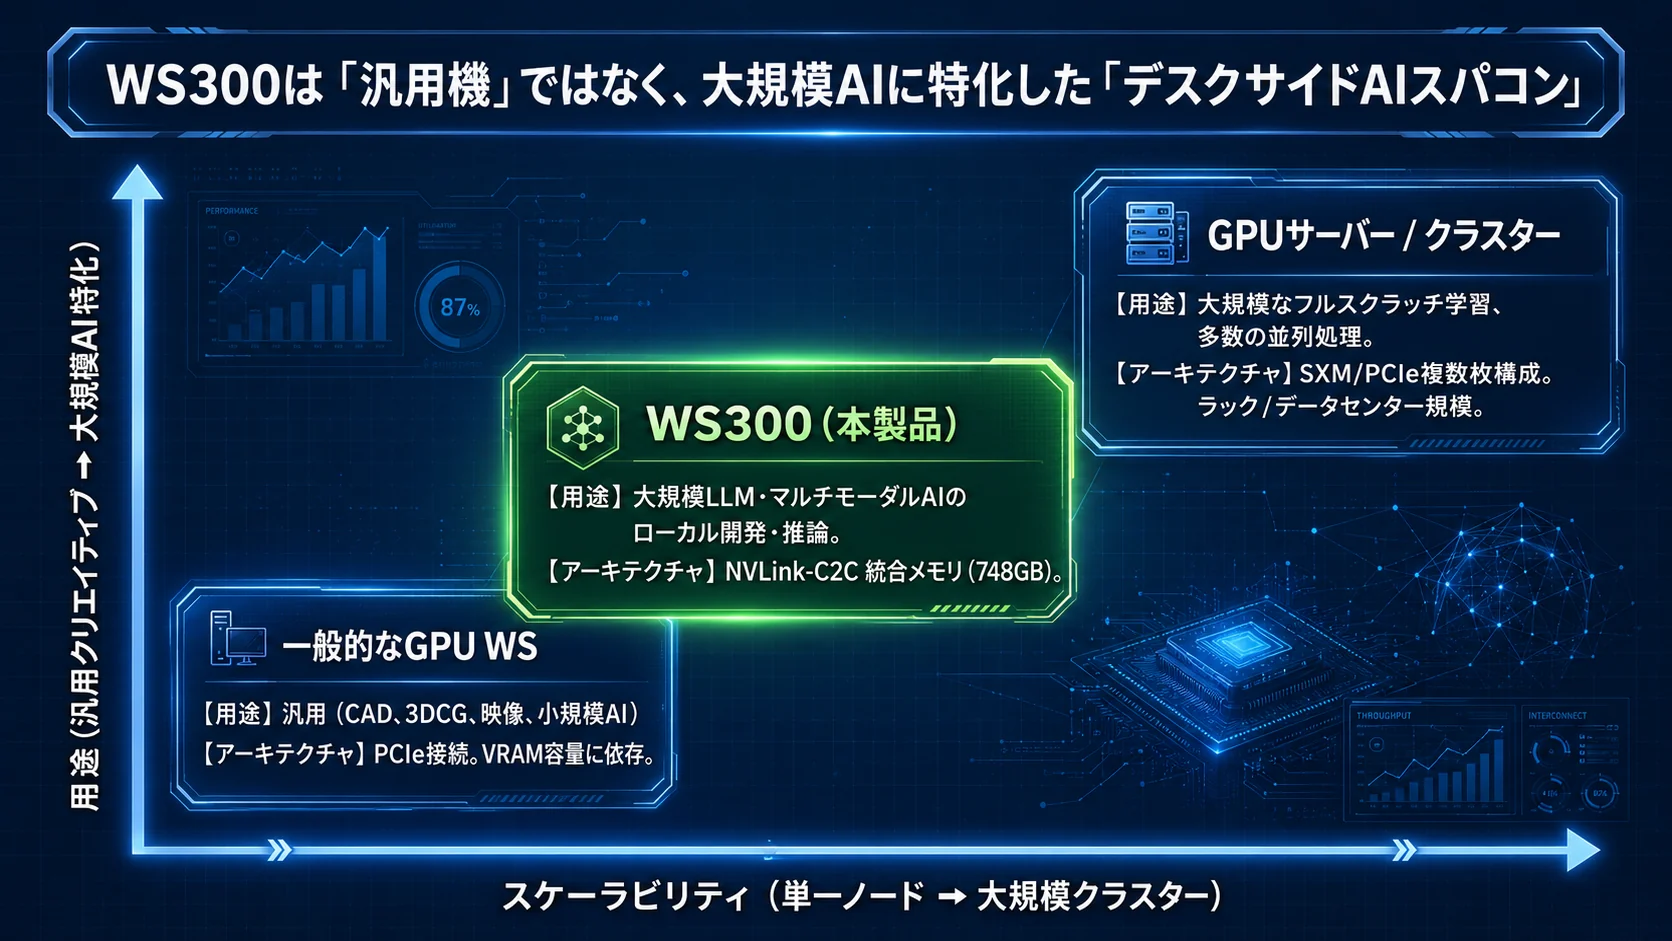
VERSATILE
CAD、CAE、3DCG、映像、画像AI、小~中規模LLMに。
LARGE MODEL
大規模LLM・VLM、長コンテキスト、AIエージェントのローカル検証に。
748GB COHERENT MEMORYSCALE OUT
大規模学習、多数ユーザー、本番サービス、複数GPUの並列処理に。
BEFORE YOU CHOOSE
モデル名だけでなく、実際の使い方まで確認することで、過不足のない構成をご提案できます。
※WS300はGrace CPU(Arm64)を採用しています。x86環境向けにのみ提供されるソフトウェアや独自プログラムは、事前の互換性確認が必要です。
TALK TO OUR SPECIALIST
アプライドでは、通常のGPUワークステーションからWS300、GPUサーバーまで、利用モデルと運用環境に合わせてご提案します。